

Attention
El mecanismo que lo cambió todo
Cómo la atención permitió mirar directamente a lo relevante y abrió la puerta a los Transformers.
Hasta ahora hemos recorrido un camino: vimos cómo las RNN intentaron recordar, cómo las LSTM y GRU aprendieron a controlar la memoria con puertas, y cómo Beam Search ayudó a generar texto con cabeza.
Pero había un techo de cristal que ninguna arquitectura recurrente lograba romper:
Procesar secuencias paso a paso es demasiado lento y demasiado rígido.
La atención nació precisamente para demoler ese límite.
El problema que la atención vino a resolver
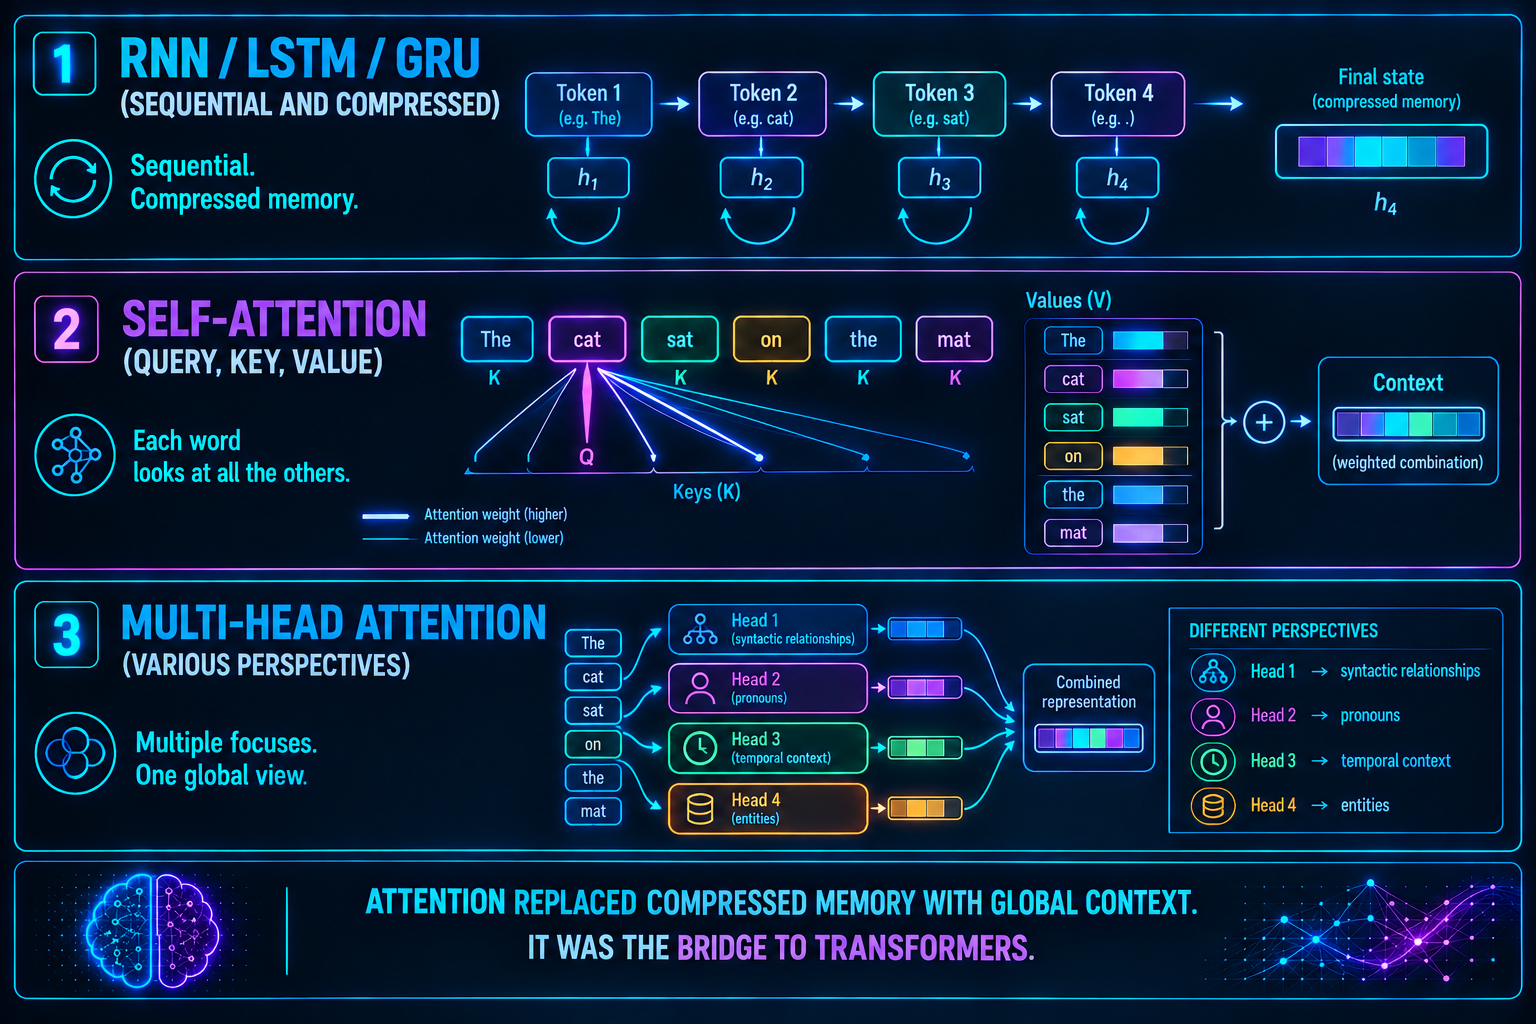
Las arquitecturas clásicas (RNN, LSTM, GRU) arrastraban dos cadenas muy pesadas:
1. Eran estrictamente secuenciales. Cada paso dependía obligatoriamente del anterior. Es como una cadena de montaje donde el segundo operario no puede empezar hasta que el primero termina: imposible aprovechar la potencia brutal de las GPU modernas, que están diseñadas para hacer miles de cosas a la vez.
2. La memoria seguía siendo un cuello de botella. Aunque las LSTM y GRU mejoraron la retención, seguían obligadas a comprimir todo el significado de un texto en un único vector de estado oculto.
La analogía del post-it. Imagina leer una novela de 500 páginas palabra por palabra y, al terminar, intentar resumir cada detalle exacto en una única nota adhesiva. Si al final alguien te pregunta un detalle de la página 12, es casi seguro que ya se te habrá borrado o difuminado.
La atención planteó un cambio radical de mentalidad:
«¿Y si en vez de forzar a la red a recordarlo todo de golpe en un post-it, le permitimos tener el libro abierto y mirar directamente a las páginas clave cuando tenga que responder?»
La idea central: Query, Key y Value
Para entender la atención sin perderte en el álgebra, piensa en un buscador como YouTube o en una biblioteca:
- Query (Consulta, $Q$): lo que estás buscando ahora mismo (la palabra o concepto que quieres descifrar).
- Key (Etiqueta o índice, $K$): el título o la etiqueta de cada elemento disponible en la frase.
- Value (Contenido, $V$): la información real que aporta cada palabra.
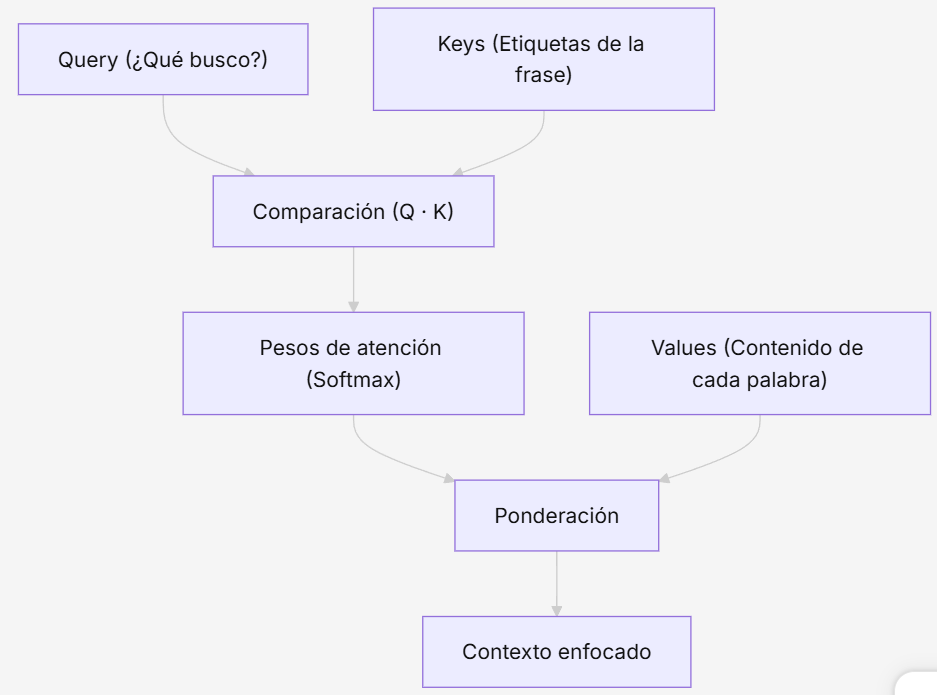
El mecanismo sigue una lógica en tres pasos:
- Compara la Query con todas las Keys para medir cuán relevante es cada palabra de la frase.
- Convierte esas relevancias en porcentajes de importancia (pesos que suman 100%).
- Extrae y combina los Values, dando más peso a las palabras más relevantes.
Matemáticamente: la fórmula que mueve el mundo
En el paper fundacional se definió mediante la Scaled Dot-Product Attention:
Leída en lenguaje natural, es asombrosamente intuitiva:
- $Q K^T$ (producto escalar): mide la afinidad entre lo que busco ($Q$) y lo que hay disponible ($K$). Si encajan, el resultado es alto.
- $\sqrt{d_k}$ (escalado): un simple factor de corrección para evitar que los números crezcan demasiado y desestabilicen los gradientes (recuerda el exploding gradient del capítulo anterior).
- $\text{softmax}(\dots)$: convierte esas puntuaciones de afinidad en probabilidades (pesos entre 0 y 1).
- $V$ (valores): multiplica esos pesos por el contenido real de cada palabra.
Es, literalmente, un mecanismo que calcula un resaltador fluorescente dinámico sobre el texto: subraya con más fuerza lo que importa y deja en gris lo irrelevante.
Self-Attention: las palabras hablando entre sí
En los modelos de lenguaje modernos, la variante reina es la Self-Attention (autoatención).
En lugar de comparar dos frases distintas (como en la traducción inglés → español), cada palabra de una frase se compara contra todas las demás palabras de su misma frase.
Mira este dilema clásico:
«El animal no cruzó la calle porque estaba demasiado cansado.»
¿Quién estaba cansado? ¿El animal o la calle? Mediante Self-Attention, la palabra «estaba» calcula su afinidad con todas las demás y descubre que su mayor peso de atención apunta directo a «animal». No necesita reglas preprogramadas: el contexto emerge por pura interacción entre las palabras.
Esto es lo que permite capturar contexto global, resolver ambigüedades y modelar el significado de forma distribuida. Self-attention es, sin exagerar, el corazón de los Transformers.
Multi-Head Attention: mirar desde varios ángulos
Los humanos no procesamos una frase prestando atención a una sola cosa a la vez. Cuando lees:
«El banco central subió los tipos porque temía la inflación.»
Tu cerebro conecta simultáneamente relaciones sintácticas (quién realiza la acción), semánticas (qué tipo de banco es, no el de sentarse) y de causa-efecto (por qué lo hizo).
Los Transformers imitan esto con la Multi-Head Attention (atención multicabeza): en lugar de un único foco, dividen el cálculo en varias «cabezas» paralelas, cada una especializada.
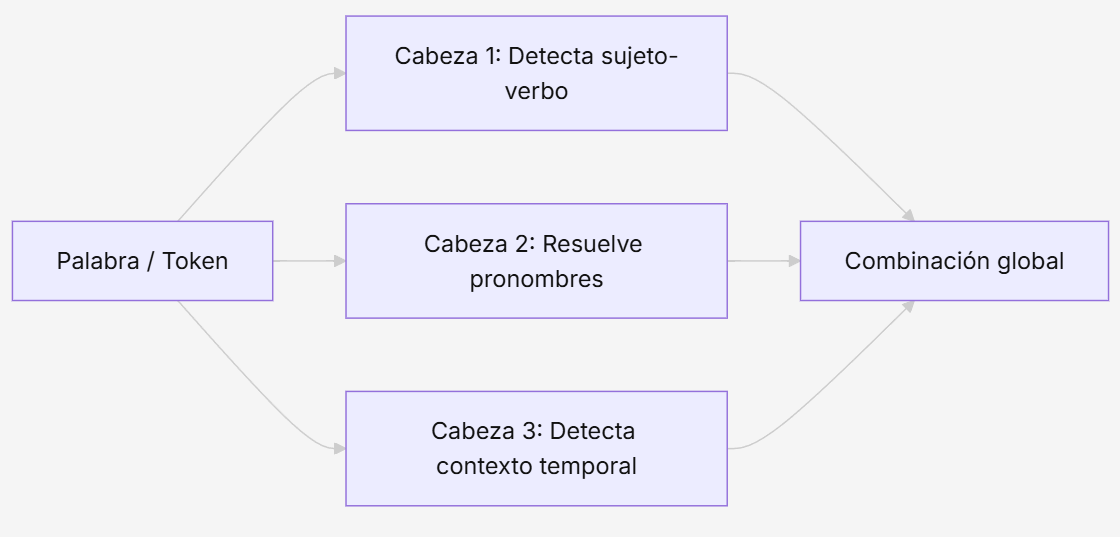
Una cabeza vigila la concordancia gramatical, otra conecta pronombres distantes, otra detecta el tono. Luego todas esas visiones se fusionan en una representación enriquecida. Es como tener varios lectores expertos analizando la misma frase a la vez, cada uno con su especialidad.
El cambio de paradigma: Recurrencia vs. Atención
La atención demostró ser superior en cada aspecto crítico del procesamiento del lenguaje:
| Desafío | RNN / LSTM / GRU | Atención |
|---|---|---|
| Conectar palabras distantes | Difícil (la señal se diluye por el camino) | Directo (distancia de cálculo = 1) |
| Paralelización en GPU | Imposible (paso a paso obligatorio) | Total (toda la matriz a la vez) |
| Velocidad de entrenamiento | Lenta | Extremadamente rápida |
| Contexto resultante | Comprimido en un solo vector | Dinámico y global para cada token |
| Escalabilidad | Limitada por la secuencia | Masiva (miles de millones de parámetros) |
La atención no es una mejora incremental: es un cambio de paradigma. Pasamos de leer palabra por palabra a leer toda la frase de golpe y resaltar lo importante.
«Attention Is All You Need» y el nacimiento de los Transformers
Hasta 2017, la atención se usaba solo como un «accesorio de apoyo» para mejorar las redes recurrentes.
Pero ese año, los investigadores de Google publicaron el paper histórico: «Attention Is All You Need». Su tesis fue demoledora:
«Podemos tirar a la basura las RNN, las LSTM y las convoluciones. La atención, por sí sola, es suficiente.»
Así nació la arquitectura Transformer, construida únicamente sobre:
- self-attention
- multi-head attention
- capas feed-forward
- normalización (LayerNorm)
- conexiones residuales
Sin recurrencia. Sin convoluciones. Solo atención.
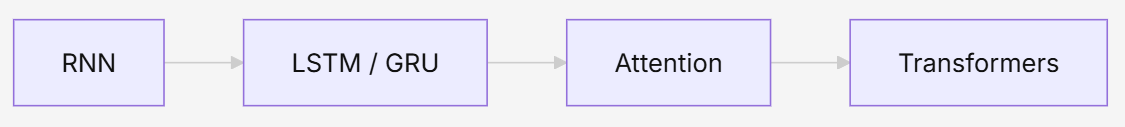
Ese diseño eliminó el cuello de botella secuencial y permitió escalar el entrenamiento sobre volúmenes masivos de datos de internet, dando origen directo a GPT-4, Claude, Gemini y toda la revolución actual de la IA generativa.
En resumen
La atención redefinió el procesamiento de secuencias:
- Eliminó el cuello de botella de comprimir toda la información en una memoria finita.
- Habilitó la paralelización total, permitiendo entrenar en tiempos antes inviables.
- Creó contexto dinámico, donde cada palabra se redefine según las que la acompañan.
Es el puente entre las arquitecturas recurrentes y los Transformers. Fue el momento exacto en el que el procesamiento de lenguaje dejó de leer «a ciegas y con prisa» para empezar a analizar el lenguaje de forma verdaderamente contextual.