

Vision Transformers (ViT): cuando las imágenes aprendieron a hablar el idioma de los Transformers
Parches, embeddings, atención global y el salto que cambió la visión por computadora
Cómo funciona la arquitectura que desafió el reinado de las CNN y abrió de par en par las puertas de la multimodalidad moderna.
Durante casi una década entera (2012–2020), las Redes Convolucionales (CNN) gobernaron la visión por computadora con mano de hierro. Eran rápidas, eficientes, elegantes y profundamente intuitivas.
Pero arrastraban una limitación estructural de nacimiento:
Las CNN solo pueden ver el mundo a través de pequeñas ventanas locales.
Como vimos en el capítulo anterior, una convolución funciona como una linterna pequeña: ilumina una baldosa diminuta de píxeles (3×3 o 5×5), detecta un borde o una textura, y necesita decenas de capas apiladas para que esa información local, poco a poco, logre armar una imagen global en la mente de la red.
En 2017, los Transformers demostraron en el mundo del texto que la atención no necesita avanzar paso a paso: funciona como los focos de un estadio entero, iluminando e interconectando todo el escenario a la vez.
Así que la pregunta atrevida era solo cuestión de tiempo:
¿Y si dejamos de tratar las imágenes como matrices de píxeles y las leemos como si fueran frases?
¿Y si cada pedazo de una imagen fuera, simplemente, una «palabra»?
En 2020, el equipo de Google Research publicó un paper con un título que ya era una declaración de intenciones: «An Image is Worth 16×16 Words» (una imagen vale 16×16 palabras). Con él nació el Vision Transformer (ViT), y provocó un terremoto conceptual en la inteligencia artificial.
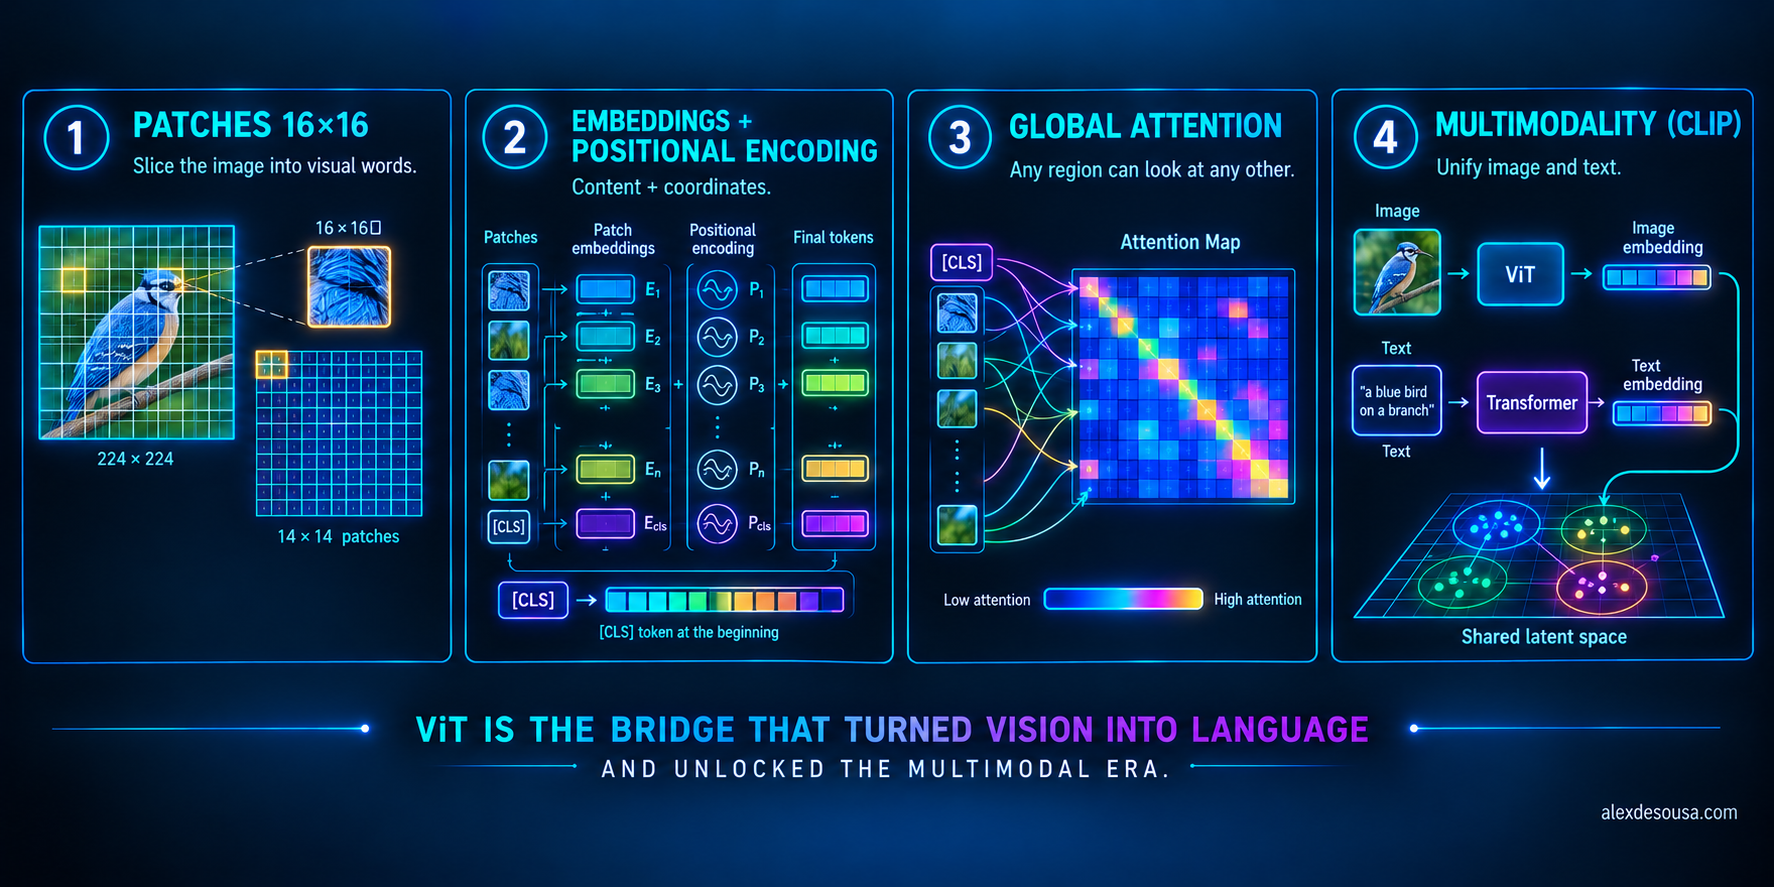
1. La idea fundacional: trocear la foto en «palabras visuales»
Un Transformer clásico exige una secuencia unidimensional (una lista ordenada de palabras: 1, 2, 3…). Una fotografía, en cambio, es una cuadrícula bidimensional de píxeles (alto × ancho × canales de color).
¿Por qué no meter los píxeles uno a uno y ya está? Porque sería un suicidio computacional. Una foto estándar de 224×224 píxeles tiene más de 50.000 píxeles, y el coste de la atención crece al cuadrado respecto al número de tokens ($O(N^2)$). Procesar 50.000 tokens haría estallar la memoria de cualquier GPU.
La solución fue tan simple como elegante: convertir la imagen en un puzle.

El proceso tiene tres pasos:
- Se divide la imagen en una cuadrícula fija de parches (típicamente de 16×16 píxeles).
- Para una imagen de 224×224, esto produce exactamente:
- Cada parche (que contiene $16 \times 16 \times 3 = 768$ valores numéricos de color) se aplana en una lista y se proyecta, mediante una matriz matemática, a un vector de dimensión fija $D$.
El resultado son 196 vectores. Y aquí está el truco mental decisivo: para el modelo, esos 196 trozos de imagen son exactamente lo mismo que una frase de 196 palabras. La imagen ha dejado de ser una cuadrícula rígida de píxeles; ahora es un texto visual que el Transformer puede leer de principio a fin.
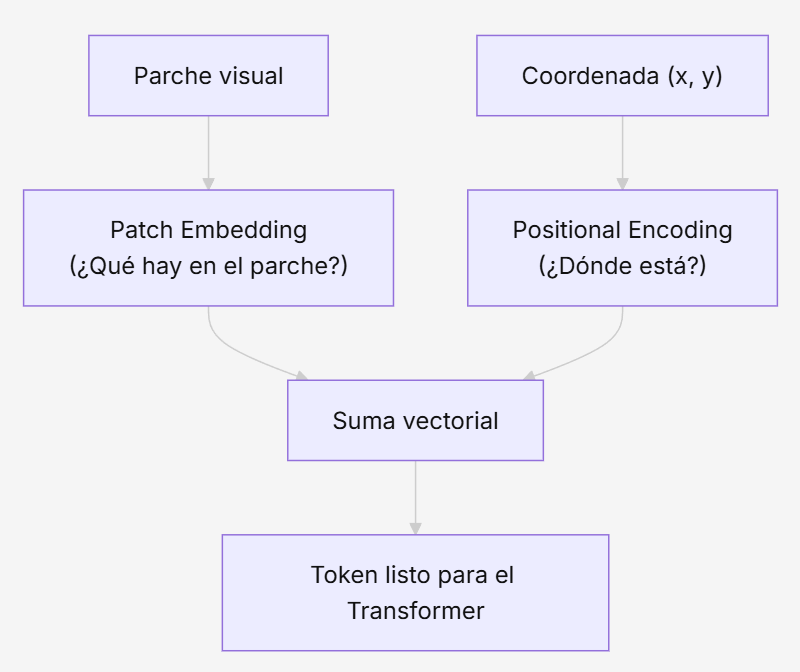
2. Embeddings y Positional Encoding: ¿dónde va cada pieza del puzle?
Un Transformer puro sufre de «amnesia espacial»: procesa todas las entradas a la vez, en una bolsa desordenada. Si barajaras los 196 parches de la foto de un gato, la atención pura no notaría la diferencia, y no sabría si la oreja está en la cabeza o pegada a la pata.
Para resolverlo, ViT hereda dos trucos directamente del procesamiento del lenguaje (NLP):
- Patch Embedding (qué hay en el parche): el vector que describe el contenido visual del trozo (colores, bordes, texturas).
- Positional Encoding (dónde está el parche): se le suma a cada parche un vector numérico que codifica sus coordenadas en el puzle (parche 1: arriba a la izquierda; parche 196: abajo a la derecha). Gracias a esto, el modelo conserva la geometría y la topología de la imagen.
Además, igual que hacía BERT en texto, se añade al inicio de la secuencia un token ficticio especial llamado[CLS]. Piensa en él como un «secretario» que no aporta contenido propio, sino que escucha a los 196 parches mediante atención, toma notas de todo y, al final, es el único que se conecta a la capa de salida para responder la pregunta: ¿esto es un perro, un coche o un avión?
3. Atención global: el superpoder que le faltaba a la visión
Una vez que los parches entran en el Transformer Encoder, ocurre el verdadero salto respecto a las CNN: la atención global inmediata (self-attention).
En una CNN tradicional, la primera capa solo puede comparar un píxel con sus vecinos inmediatos. Para que la señal de la esquina superior izquierda logre «hablar» con la inferior derecha, tiene que viajar a través de decenas de capas convolucionales intermedias, perdiendo detalle por el camino.
En un ViT, desde la Capa 1, cualquier parche puede dialogar directamente con cualquier otro parche de la imagen, sin intermediarios.
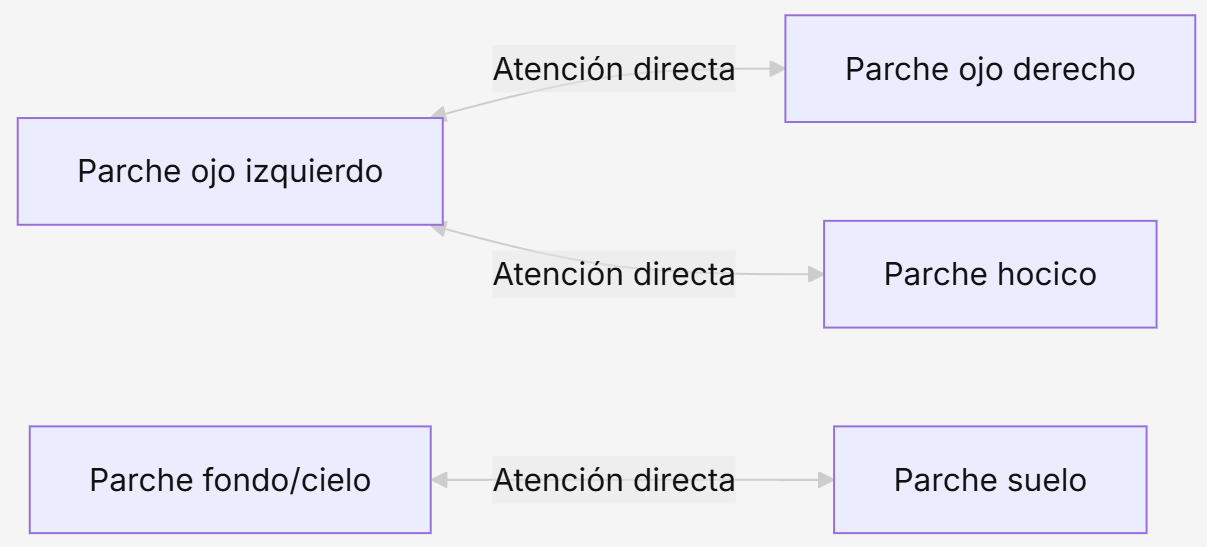
Esto le permite al modelo, en un solo paso:
- relacionar ambos ojos entre sí para medir la simetría de un rostro,
- entender el contorno completo de un coche aunque una farola tape el centro,
- conectar un tumor con el borde del tejido sano que lo rodea,
- y separar de golpe el objeto protagonista del fondo desenfocado.
4. ¿Por qué ViT superó a las CNN? La cuestión del sesgo inductivo
Las CNN dominaron tanto tiempo porque vienen con un «truco» biológico incorporado de fábrica: el sesgo inductivo (inductive bias). Asumen por diseño dos reglas del mundo físico:
- Localidad: los píxeles cercanos suelen pertenecer a la misma cosa.
- Invarianza por traslación: una manzana sigue siendo una manzana tanto si está en la esquina como en el centro de la foto.
Ese sesgo es como darle al modelo un libro de instrucciones de regalo: aprende rapidísimo incluso con pocos datos.
ViT, en cambio, no asume absolutamente nada. No sabe de antemano qué es el espacio 2D, ni que los píxeles adyacentes guardan relación. Llega a clase con la mente en blanco y tiene que aprender la física y la geometría visual desde cero, a base de ver millones de ejemplos.
| Característica | Convoluciones (CNN) | Vision Transformers (ViT) |
|---|---|---|
| Campo de visión inicial | Local (ventanas de 3×3) | Global (toda la imagen desde el paso 1) |
| Sesgo espacial incorporado | Muy alto (asume geometría 2D de serie) | Casi nulo (aprende las relaciones por sí mismo) |
| Rendimiento con pocos datos | Excelente (aprende rápido) | Pobre (se pierde sin referencias) |
| Escalabilidad con datos masivos | Tiende a estancarse (plateau) | Crece sin techo aparente |
| Estructura | Convoluciones + pooling + kernels | Capas idénticas de Self-Attention + MLP |
5. El shock de 2020: la sed insaciable de datos
Cuando Google presentó ViT, los resultados iniciales desconcertaron a toda la comunidad:
- Entrenado sobre ImageNet (1,3 millones de fotos): ViT rendía peor que una ResNet convencional.
- Entrenado sobre JFT-300M (300 millones de fotos privadas de Google): ViT aplastaba a cualquier CNN existente.
¿La moraleja? Al no tener sesgos preconfigurados, ViT necesita millones y millones de ejemplos solo para intuir cómo funciona la continuidad visual del mundo. Pero una vez que supera ese umbral de datos, ya no tiene la rigidez que limita a una CNN. Es una arquitectura nacida por y para la escala masiva.
ViT es una arquitectura de escala: cuantos más datos le das, más brilla.
6. La evolución: democratización y arquitecturas híbridas
El requisito de necesitar 300 millones de fotos dejaba a ViT fuera del alcance de casi todo el mundo. La comunidad respondió enseguida con variantes más listas y accesibles:
- DeiT (Data-efficient Image Transformers): desarrollado por Meta, usó destilación (un modelo «profesor» CNN que le enseña los trucos a un «alumno» Transformer) para demostrar que ViT podía entrenarse de forma competitiva solo con ImageNet, sin datasets titánicos.
- Swin Transformer: introdujo la atención por ventanas jerárquicas desplazadas. En lugar de mirar los 196 parches de golpe, procesa ventanas locales que se van fusionando y ampliando en las capas más profundas. Es la fusión perfecta entre la eficiencia local de una CNN y la flexibilidad global de un Transformer, y hoy es uno de los modelos más usados en producción.
- Modelos gigantes (ViT-H, ViT-G, ViT-22B): escalas colosales con miles de millones de parámetros que sirven de columna vertebral para motores de visión de frontera como PaLI, Gemini y Flamingo.
7. El puente definitivo hacia la multimodalidad: CLIP
Aquí está el verdadero legado de ViT, y no es clasificar fotos un 2% mejor que una CNN: fue unificar los formatos matemáticos de la inteligencia artificial.
Antes de ViT, el lenguaje se procesaba como secuencias (Transformers) y la visión como matrices continuas (CNN). Eran dos mundos hablando idiomas incompatibles, incapaces de entenderse.
Al convertir la imagen en una secuencia de tokens, imagen y texto pasaron a ser, estructuralmente, lo mismo.
El mejor ejemplo es CLIP (OpenAI):
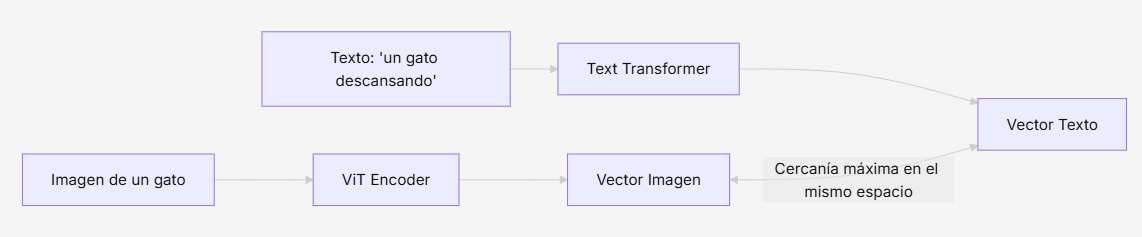
- Un ViT procesa la imagen y devuelve un vector.
- Un Transformer procesa el texto y devuelve otro vector.
- Ambos modelos se entrenan juntos para que la foto del gato y la frase «un gato descansando» aterricen en el mismo punto de coordenadas de un espacio latente compartido.
De este espacio común nacieron la búsqueda semántica de imágenes (buscar fotos escribiendo lo que quieres, sin etiquetas), la clasificación zero-shot (reconocer objetos que el modelo nunca vio en el entrenamiento), las herramientas de generación como Stable Diffusion y Midjourney (que «entienden» qué dibujar gracias a CLIP) y los ojos de modelos como GPT-4o Vision y Gemini Vision.
8. ViT vs. CNN en la actualidad: ¿quién se queda la corona?
No hay un ganador absoluto. Se han repartido el terreno de juego según el hardware y la tarea:
| Escenario | Gana la CNN 🏃 | Gana el ViT 🧠 |
|---|---|---|
| Dispositivos móviles y edge | ✔ Ligera, rápida, poca batería | |
| Baja latencia y poca memoria | ✔ | |
| Tareas visuales simples | ✔ | |
| Datasets masivos | ✔ Escala sin techo | |
| Modelos gigantes y multimodalidad | ✔ La base de la IA moderna | |
| Investigación de frontera | ✔ |
En resumen de este reparto: las CNN siguen reinando en el presente práctico (cámaras de seguridad, teléfonos, drones, dispositivos médicos portátiles), mientras que ViT domina la frontera (grandes modelos fundacionales, sistemas multimodales y generación de imágenes de alta fidelidad).
La CNN domina el presente. El ViT domina el futuro.
En resumen
Los Vision Transformers supusieron un cambio de paradigma indiscutible:
- Trocean la imagen en parches de 16×16 píxeles y los tratan como si fueran palabras de una frase.
- Añaden coordenadas (Positional Encoding) para no perder la geometría, y un token
[CLS]que resume todo para clasificar. - Aplican atención global desde la primera capa, dejando que cualquier región de la foto se relacione con cualquier otra de forma directa.
- Prescinden de convoluciones, kernels y pooling, sustituyéndolos por capas de atención puras y escalables.
- Necesitan muchos datos para arrancar, pero a cambio escalan sin techo.
- Habilitaron la revolución multimodal al unificar imagen y texto bajo un único estándar matemático, siendo la base de CLIP, PaLI, Flamingo, Gemini Vision y GPT-4o Vision.
Fue el momento exacto en el que las imágenes dejaron de ser cuadrículas de píxeles examinadas por el ojo de una cerradura… y se convirtieron en lenguaje.