

Transformers
La arquitectura que redefinió el NLP moderno
Hoy hablaremos de los Transformers y no precisamente de estos Transformers…
Cómo los Transformers eliminaron la recurrencia, abrazaron la paralelización y dieron origen a los modelos de lenguaje actuales.
Hasta ahora hemos recorrido toda la evolución: vimos cómo las RNN intentaron recordar paso a paso, cómo las LSTM y GRU aprendieron a controlar la memoria con puertas, cómo el vanishing/exploding gradient saboteaba el entrenamiento profundo, cómo Beam Search ayudó a generar texto con cabeza y, en el capítulo anterior, cómo la atención permitió mirar directamente a lo relevante.
Cada pieza fue un parche brillante sobre la misma idea de fondo: la recurrencia.
Pero faltaba la pregunta atrevida, la que lo cambiaría todo:
¿Y si tiramos la recurrencia a la basura y construimos una arquitectura entera basada únicamente en atención?
En 2017, el paper de Google Attention Is All You Need respondió sin titubeos:
Sí. Y no solo funciona: arrasa con todo lo anterior.
Así nacieron los Transformers.
¿Qué es un Transformer?
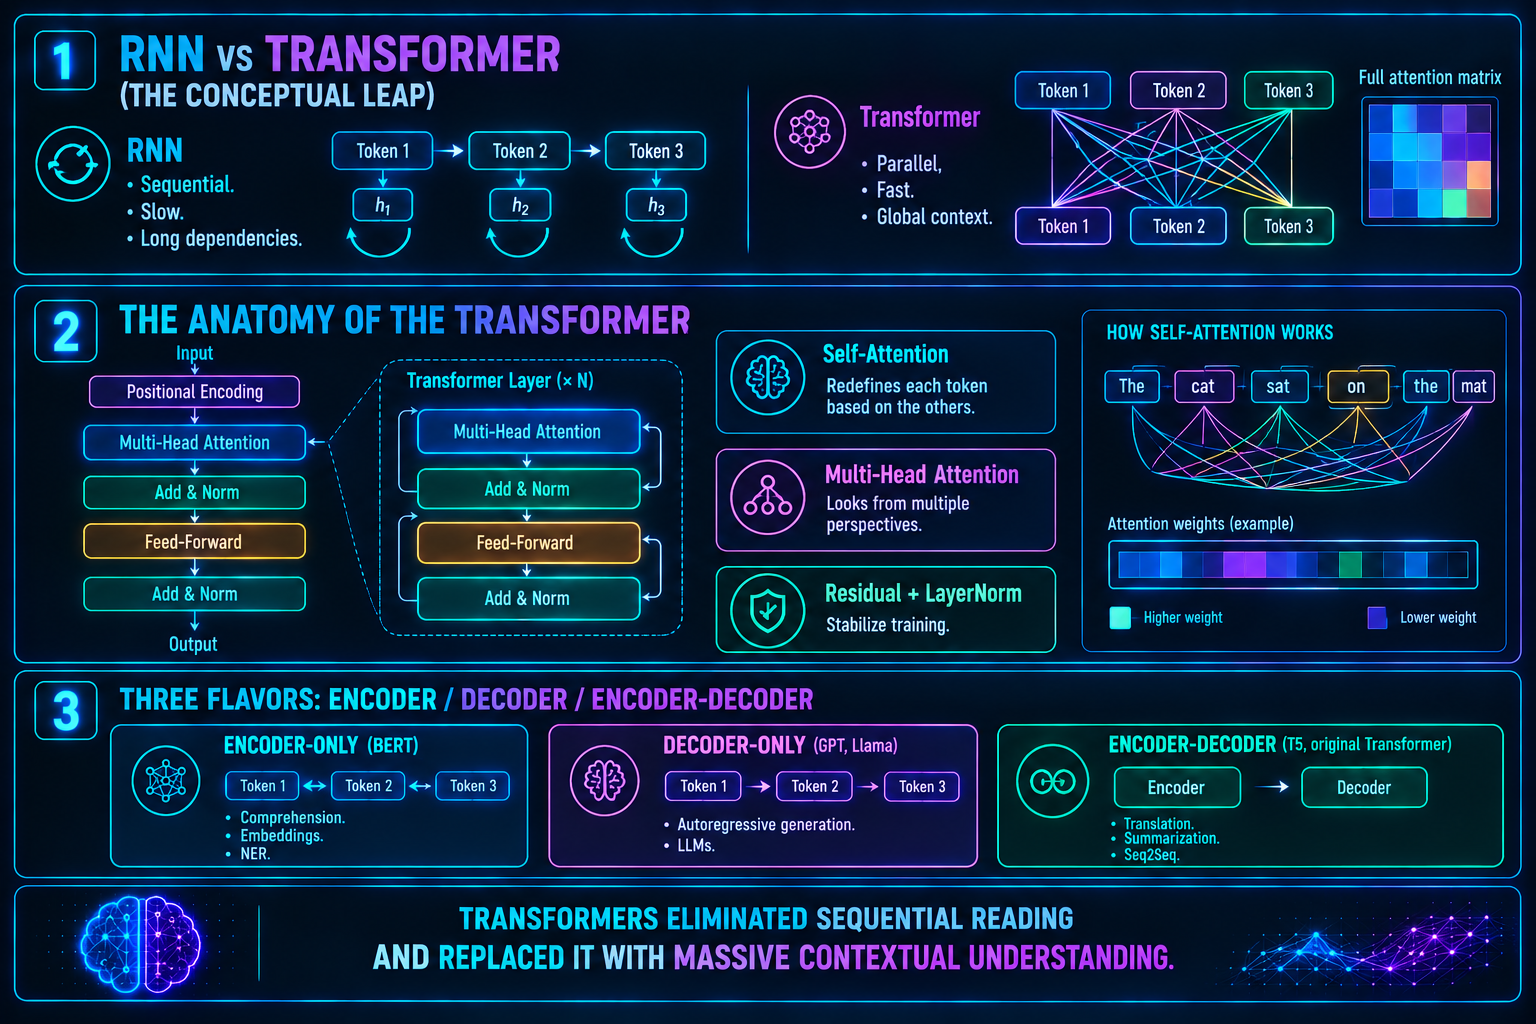
Un Transformer es una red neuronal que procesa secuencias sin bucles recurrentes y sin convoluciones. Todo su motor descansa sobre cinco piezas:
- Self-attention (autoatención)
- Multi-head attention (atención multicabeza)
- Capas Feed-Forward (FFN)
- Normalización (LayerNorm)
- Conexiones residuales
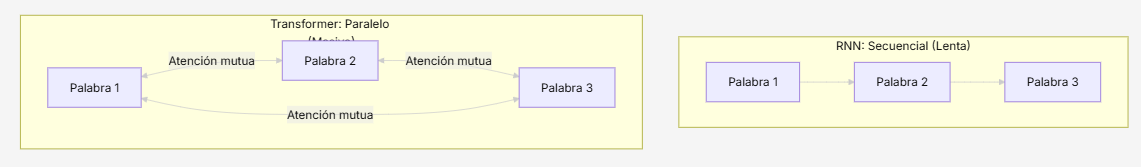
La analogía de la lectura. Una RNN lee como un estudiante agotado a las 3 de la madrugada: palabra por palabra, intentando retener en la cabeza lo que leyó tres páginas atrás. Un Transformer, en cambio, hace una fotografía aérea de la página entera y observa todas las palabras a la vez, decidiendo al instante cuáles se relacionan entre sí.
Al mirar todo en simultáneo, elimina el cuello de botella secuencial y exprime al máximo la capacidad de cálculo en paralelo de las GPU modernas.
¿Por qué fue una revolución frente a las RNN?
Los Transformers derribaron de un solo golpe los dos muros que frenaban a las redes recurrentes:
| Desafío | Enfoque RNN | Enfoque Transformer |
|---|---|---|
| Velocidad de entrenamiento | Token a token (imposible paralelizar el tiempo) | Todos los tokens a la vez (paralelización masiva) |
| Dependencias a larga distancia | La señal cruza decenas de pasos y se degrada (vanishing gradient) | La distancia entre cualquier par de palabras es exactamente 1 |
Ese detalle de la distancia lógica 1 es clave: una palabra situada al final de un documento de 4.000 tokens puede consultar de forma directa el inicio del texto, sin intermediarios ni pérdida de memoria por el camino. Fue justo esto lo que abrió la puerta a entrenar sobre corpus descomunales de internet.
La anatomía del Transformer, pieza a pieza
Aunque existen variantes, todos los Transformers comparten los mismos bloques fundamentales apilados en capas.
1. Embeddings + Positional Encoding
La atención pura es ciega al orden: ve la frase como una bolsa de palabras flotando sin filas ni turnos. Por sí sola no distinguiría «el perro mordió al hombre» de «el hombre mordió al perro».
El Positional Encoding inyecta una señal matemática (un patrón de ondas y posiciones) que le indica a cada token exactamente qué lugar ocupa en la fila. Es como ponerle un número de asiento a cada palabra.
2. Self-Attention (Autoatención)
Cada token se pregunta: «¿Qué otras palabras de esta frase necesito mirar para entender mi propio significado?».
En la frase «El animal no cruzó la calle porque estaba cansado», la palabra «estaba» dirige su atención con fuerza hacia «animal» y prácticamente ignora «calle». El contexto emerge solo, sin reglas programadas a mano.
3. Multi-Head Attention (Atención multicabeza)
En vez de una única atención global, el Transformer lanza varios «cabezales» en paralelo, cada uno especializado en un tipo de relación:
- Uno rastrea la sintaxis (sujeto–verbo).
- Otro resuelve pronombres y correferencias (él, aquello).
- Otro detecta entidades y nombres propios.
- Otro capta el contexto temporal.
Luego todas esas perspectivas se concatenan en una única representación enriquecida. Es como tener varios lectores expertos analizando la misma frase a la vez.
4. Feed-Forward Networks (FFN)
Tras la atención, cada token pasa por una pequeña red densa que procesa, refina y proyecta la información recién capturada. Es el paso donde el modelo «digiere» lo que la atención le acaba de señalar.
5. Residual Connections + LayerNorm
Las conexiones residuales crean autopistas por donde los gradientes viajan sin degradarse (adiós de nuevo al vanishing gradient), y LayerNorm mantiene los valores numéricos estables entre capa y capa para que nada se dispare.
Los tres sabores: Encoder, Decoder o ambos
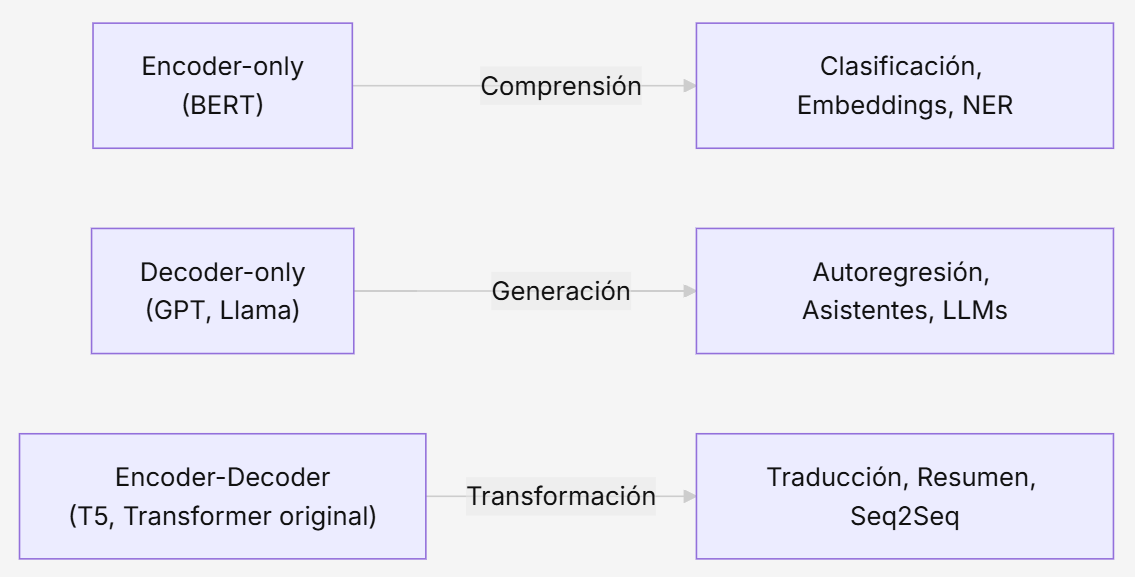
Según cómo se ordenen estos bloques, obtenemos tres grandes familias de arquitecturas:
| Arquitectura | Modelo emblemático | Especialidad | Cómo procesa el contexto |
|---|---|---|---|
| Encoder-only | BERT | Comprensión y análisis | Bidireccional total (mira pasado y futuro) |
| Decoder-only | GPT, Llama | Generación autoregresiva | Causal (solo mira las palabras anteriores) |
| Encoder-Decoder | T5, BART | Transformación de secuencias | El encoder lee la entrada, el decoder genera la salida |
¿Por qué escalan tan bien?
El éxito arrollador de los Transformers no vino solo de su elegancia matemática, sino de su enamoramiento con el hardware:
- Operaciones matriciales masivas: multiplicar matrices gigantes es exactamente para lo que nacieron las GPU y las TPU.
- Entrenamiento distribuido: miles de tarjetas pueden procesar lotes enteros a la vez, sin esperar dependencias temporales paso a paso.
- Leyes de escala (Scaling Laws): a más parámetros y más datos, el rendimiento mejora de forma predecible, sin estancarse.
Optimizaciones recientes como FlashAttention (una gestión mucho más inteligente de la memoria de la GPU) y codificaciones como RoPE han estirado las ventanas de contexto desde los 512 tokens del paper original hasta cientos de miles o incluso millones.
El impacto global: mucho más allá del texto
Hoy, prácticamente cualquier modelo de vanguardia —GPT-4o, Claude, Gemini, Llama— es un Transformer por dentro. Y la arquitectura rompió las fronteras del lenguaje:
- Vision Transformers (ViT): tratan las imágenes dividiéndolas en pequeños parches, como si cada trozo fuera una «palabra».
- Audio y voz: modelos como Whisper transcriben procesando espectrogramas.
- Multimodalidad: texto, imagen, vídeo y código conviviendo en un mismo espacio latente.
- Mixture of Experts (MoE): disparan el número de parámetros activando solo subredes especializadas para cada token, ganando tamaño sin disparar el coste.
Los Transformers no solo cambiaron el NLP: redibujaron toda la inteligencia artificial.
En resumen
Los Transformers completaron el giro que el NLP llevaba años buscando:
- Eliminaron la recurrencia, borrando de un plumazo la lentitud secuencial.
- Habilitaron la paralelización total, permitiendo entrenar sobre prácticamente toda la web.
- Resolvieron las dependencias largas, conectando cualquier par de conceptos en un único paso.
- Escalaron a tamaños impensables, hasta miles de millones de parámetros.
- Se convirtieron en el motor de la IA moderna, demostrando que la atención no era un accesorio, sino la base de todo.
Son el puente definitivo entre la atención y la IA generativa actual. El momento exacto en el que el procesamiento de lenguaje dejó de ser una lectura lenta y a ciegas… para convertirse en una comprensión contextual, masiva y escalable.