

Vanishing / Exploding Gradient + Beam Search
Los problemas que hicieron sufrir a las redes… y la técnica que permitió generar texto con cabeza
Por qué entrenar redes profundas era tan difícil y cómo Beam Search ayudó a producir secuencias coherentes antes de los Transformers.
En capítulos anteriores vimos cómo las RNN, LSTM y GRU intentaron recordar a lo largo del tiempo. Pero incluso con esas mejoras, entrenar redes profundas seguía siendo un campo de minas.
Hoy unimos dos piezas clave de esa época, que actúan en momentos distintos:
- Vanishing / Exploding Gradient → el obstáculo durante el entrenamiento, que impedía a las redes aprender.
- Beam Search → la estrategia durante la generación, que permitió producir frases con sentido sin colapsar en el intento.
Son conceptos de etapas diferentes (entrenar vs. generar), pero juntos formaron la columna vertebral que sostuvo a los modelos de lenguaje antes de la llegada de la atención.
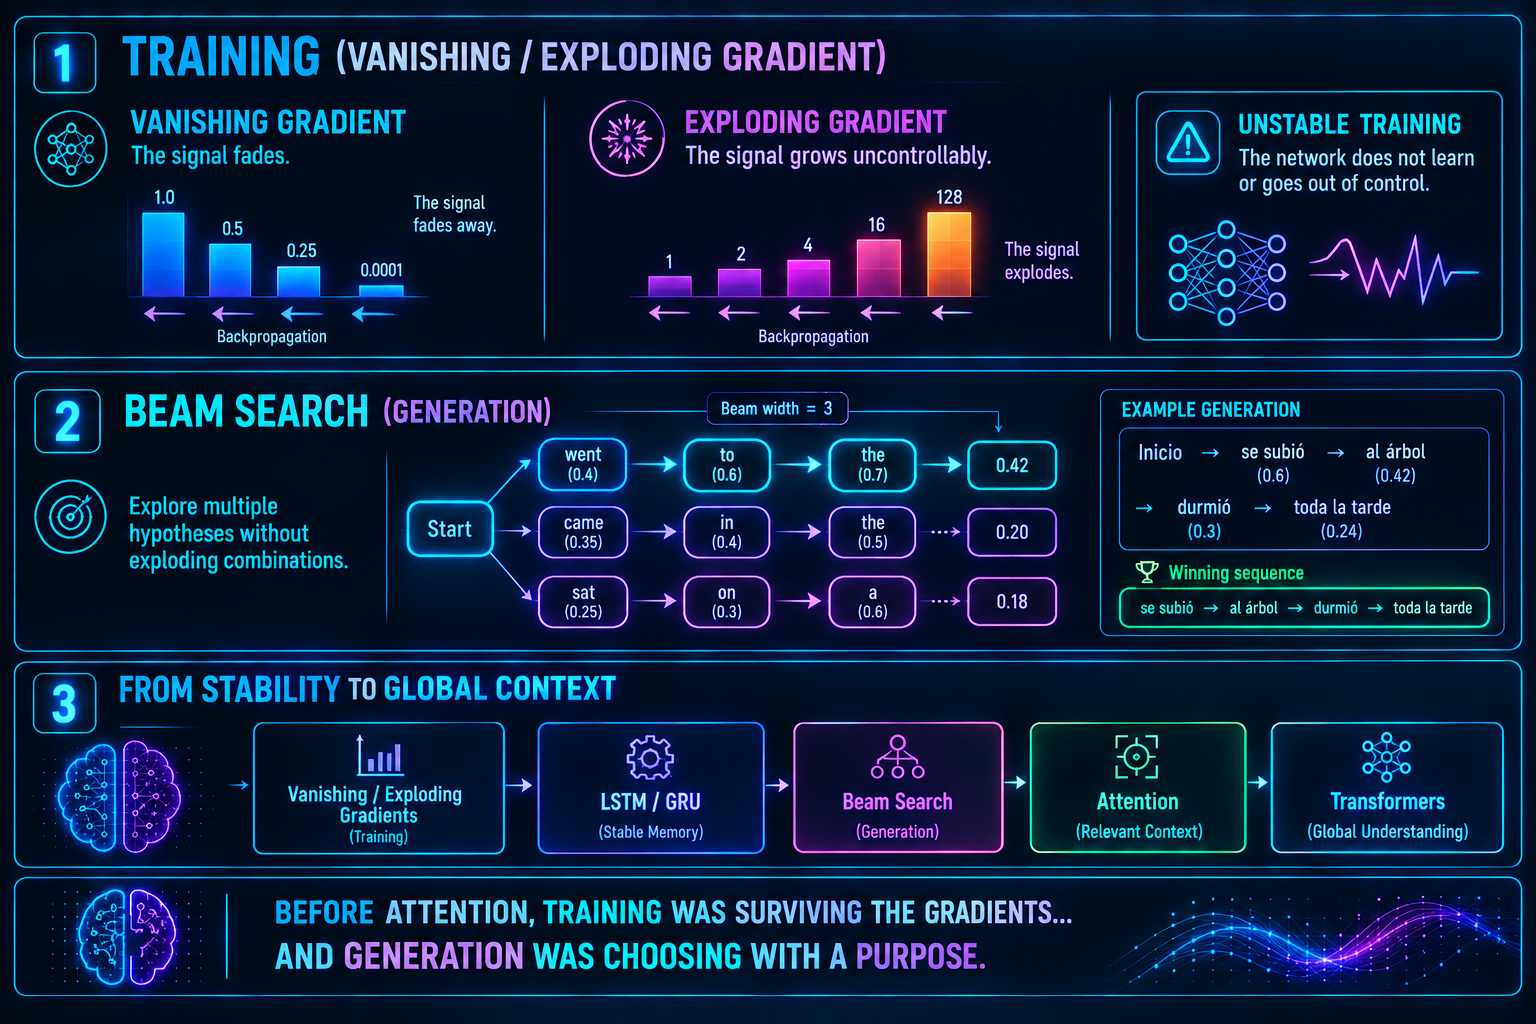
Vanishing Gradient: cuando la señal se apaga
Para que una red aprenda usamos backpropagation: calculamos el error al final y lo enviamos marcha atrás, multiplicando derivadas capa por capa mediante la regla de la cadena.
El drama aparece en redes profundas o secuencias largas: cada paso hacia atrás implica multiplicar por un factor de escala. Si esos factores son menores que 1 (algo muy común con funciones comosigmoidotanh, cuyas derivadas rara vez superan 0.25), pasa esto:
Al cabo de unas pocas capas, el valor es tan diminuto que la señal de aprendizaje desaparece por completo.

La analogía del teléfono escacharrado. Imagina gritar un mensaje a través de 30 habitaciones, pero cada persona lo repite a la mitad de volumen que la anterior. En la quinta habitación es un susurro; en la primera, nadie se entera de qué había que corregir.
¿Qué lo causa y qué consecuencias tiene?
Las causas habituales son las activaciones tiposigmoid/tanh, las multiplicaciones repetidas en secuencias largas, los pesos inicializados demasiado pequeños y las arquitecturas profundas sin memoria. El resultado siempre es el mismo:
- Amnesia temprana: los primeros pasos de la frase nunca actualizan sus pesos; la red solo recuerda lo ultimísimo que acaba de leer.
- Entrenamiento congelado: aunque la red cometa errores garrafales, las capas profundas se quedan estáticas.
Exploding Gradient: cuando la señal estalla
Ocurre el fenómeno contrario. ¿Qué pasa si los factores son mayores que 1?
En cuestión de unos pocos pasos, los gradientes crecen exponencialmente hasta desbordar la memoria.
Siguiendo la analogía: cada habitación repite el mensaje al doble de volumen. Muy pronto no hay mensaje, solo un estruendo que rompe los altavoces.
Consecuencias directas:
- Los pesos se actualizan con saltos gigantescos y caóticos.
- La función de pérdida (loss) oscila sin control o arroja el temido
NaN(Not a Number). - El modelo se descalabra y nunca converge.
El botiquín de primeros auxilios: ¿cómo se solucionó?
La comunidad diseñó soluciones estándar que seguimos usando hoy:
| Técnica | Problema que ataca | Cómo funciona |
|---|---|---|
| Gradient Clipping | Exploding | Si el vector de gradiente supera un umbral, se recorta a la fuerza antes de optimizar. |
| Inicialización Xavier / He | Ambos | Escala los pesos iniciales según el número de neuronas para que no crezcan ni encojan de partida. |
| Activaciones ReLU | Vanishing | Su derivada es exactamente 1 para valores positivos; no comprime la señal comosigmoidotanh. |
| Celdas LSTM / GRU | Vanishing | Crean «autopistas» de gradiente aditivas (sumas en vez de multiplicaciones puras). |
| Normalización (BatchNorm / LayerNorm) | Ambos | Reajusta las activaciones a media 0 y varianza 1 de forma continua. |
Estas técnicas, en conjunto, permitieron por fin entrenar redes profundas y secuenciales con estabilidad.
¿Qué tiene que ver esto con Beam Search?
Imaginemos que ya logramos esquivar los gradientes descontrolados y tenemos un modelo bien entrenado. Ahora toca ponerlo a escribir: una traducción, un resumen, una frase.
Aquí surgía el segundo cuello de botella: ¿cómo decide el modelo qué palabra poner a continuación?
- Greedy Search (búsqueda voraz): elegir siempre la palabra con mayor probabilidad inmediata.
Problema: es miope. Una palabra que parece buena ahora puede arrastrar al modelo a un callejón sin salida tres palabras después. - Búsqueda exhaustiva (fuerza bruta): calcular todas las combinaciones posibles de frases.
Problema: explosión combinatoria inmanejable ($V^T$, donde $V$ es el tamaño del vocabulario y $T$ la longitud del texto).
Para resolver ese dilema apareció Beam Search.
Beam Search: explorar caminos con cabeza
Beam Search es el equilibrio inteligente: en lugar de quedarse con una sola opción (Greedy) o probarlas todas (fuerza bruta), mantiene en paralelo un grupo selecto de las $k$ hipótesis más probables en cada paso.
A ese parámetro $k$ se le conoce como Beam Width (ancho de haz).
Un ejemplo paso a paso ($k = 2$)
Imagina que el modelo empieza a escribir tras la frase: «El gato…»
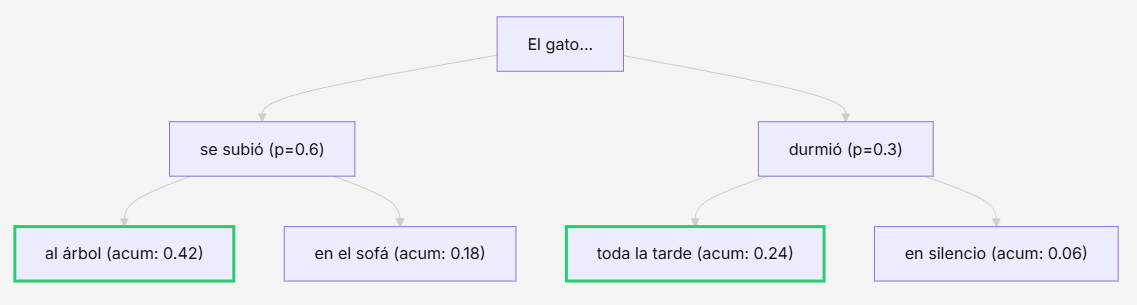
- Paso 1: el modelo calcula las probabilidades de la siguiente palabra y guarda solo las 2 mejores:
- Hipótesis A: «se subió» ($p=0.6$)
- Hipótesis B: «durmió» ($p=0.3$)
- Paso 2: desde cada una de esas 2 opciones, predice las siguientes y calcula la probabilidad conjunta acumulada.
- Paso 3: de las 4 ramificaciones resultantes, vuelve a quedarse solo con el Top-2 global:
- 1ª mejor: «El gato se subió al árbol» ($0.42$)
- 2ª mejor: «El gato durmió toda la tarde» ($0.24$)
- Descarta el resto y repite hasta llegar al token de fin de secuencia (
<EOS>).
Al final gana la frase con mayor probabilidad acumulada en su conjunto, lo que permite rectificar decisiones que parecían prometedoras al principio pero que luego no tenían sentido.
¿Por qué fue tan importante?
Porque permitió generar texto coherente, mejorar la traducción automática, evitar repeticiones absurdas y explorar alternativas sin caer en la explosión combinatoria. Antes de los Transformers, Beam Search era el estándar en generación de secuencias.
¿Sigue usándose Beam Search en la era de los LLM?
Sí, pero el panorama ha cambiado según la tarea:
- Tareas deterministas (traducción, resúmenes técnicos, transcripción de audio): Beam Search sigue siendo muy popular (por ejemplo, en sistemas tipo Whisper) porque busca la secuencia más fiel y probable.
- Modelos conversacionales y creativos (GPT-4, Claude, LLaMA): aquí Beam Search tiende a generar texto plano y repetitivo. Por eso los LLM modernos prefieren métodos estocásticos:
- Temperatura: ajusta el nivel de atrevimiento al muestrear.
- Top-k y Top-p (Nucleus Sampling): eligen palabras al azar solo dentro del grupo de candidatas razonables, produciendo texto más humano y variado.
| Método | Cómo elige | Cuándo brilla |
|---|---|---|
| Greedy | siempre la más probable | tareas triviales, máxima velocidad |
| Beam Search | mantiene el Top-$k$ de secuencias | traducción, resúmenes, transcripción |
| Sampling (Top-k / Top-p / temperatura) | muestrea entre candidatas razonables | chat, escritura creativa |
En resumen
- Vanishing Gradient apagaba la señal de aprendizaje al multiplicar derivadas diminutas en secuencias largas.
- Exploding Gradient disparaba los números hasta hacer colapsar el entrenamiento.
- Herramientas como Gradient Clipping, ReLU, LSTM/GRU y LayerNorm consiguieron domar esos gradientes.
- Beam Search resolvió la otra mitad del problema: cómo generar secuencias lógicas explorando varias alternativas a la vez sin agotar la memoria.
Ambos avances estabilizaron el entrenamiento y la inferencia de secuencias, y dejaron el camino despejado para el siguiente gran salto: prescindir de la recurrencia y dar paso al mecanismo de atención pura.