

Tokenización moderna (BPE, SentencePiece): cómo los modelos parten el lenguaje en piezas matemáticas
Subwords, merges, vocabularios y el mecanismo que permite a los LLM entender cualquier idioma, palabra nueva o errata
El capítulo que explica cómo los modelos aprenden a «leer» antes de poder pensar.
Hasta ahora hemos explorado las grandes estructuras de la IA: cómo las redes procesan secuencias, cómo prestan atención, cómo fabrican embeddings y cómo unen visión y lenguaje. Pero hay un paso previo, silencioso y absolutamente fundamental, que ocurre antes de que se active la primera neurona:
Antes de que un modelo pueda razonar, generar, traducir o responder, necesita convertir el texto en unidades que pueda procesar.
Las computadoras no entienden letras, ni palabras, ni frases: solo saben manejar números. El proceso encargado de traducir el texto crudo que escribes en piezas numéricas digeribles se llama tokenización.
Es una fase tan crítica que cambiar el tokenizador de un modelo equivale a cambiarle el alfabeto a un idioma entero: si tocas esa pieza, todo el universo interno de embeddings que el modelo había aprendido se derrumba al instante.
Durante años se probaron tres caminos… y dos de ellos fracasaron estrepitosamente.
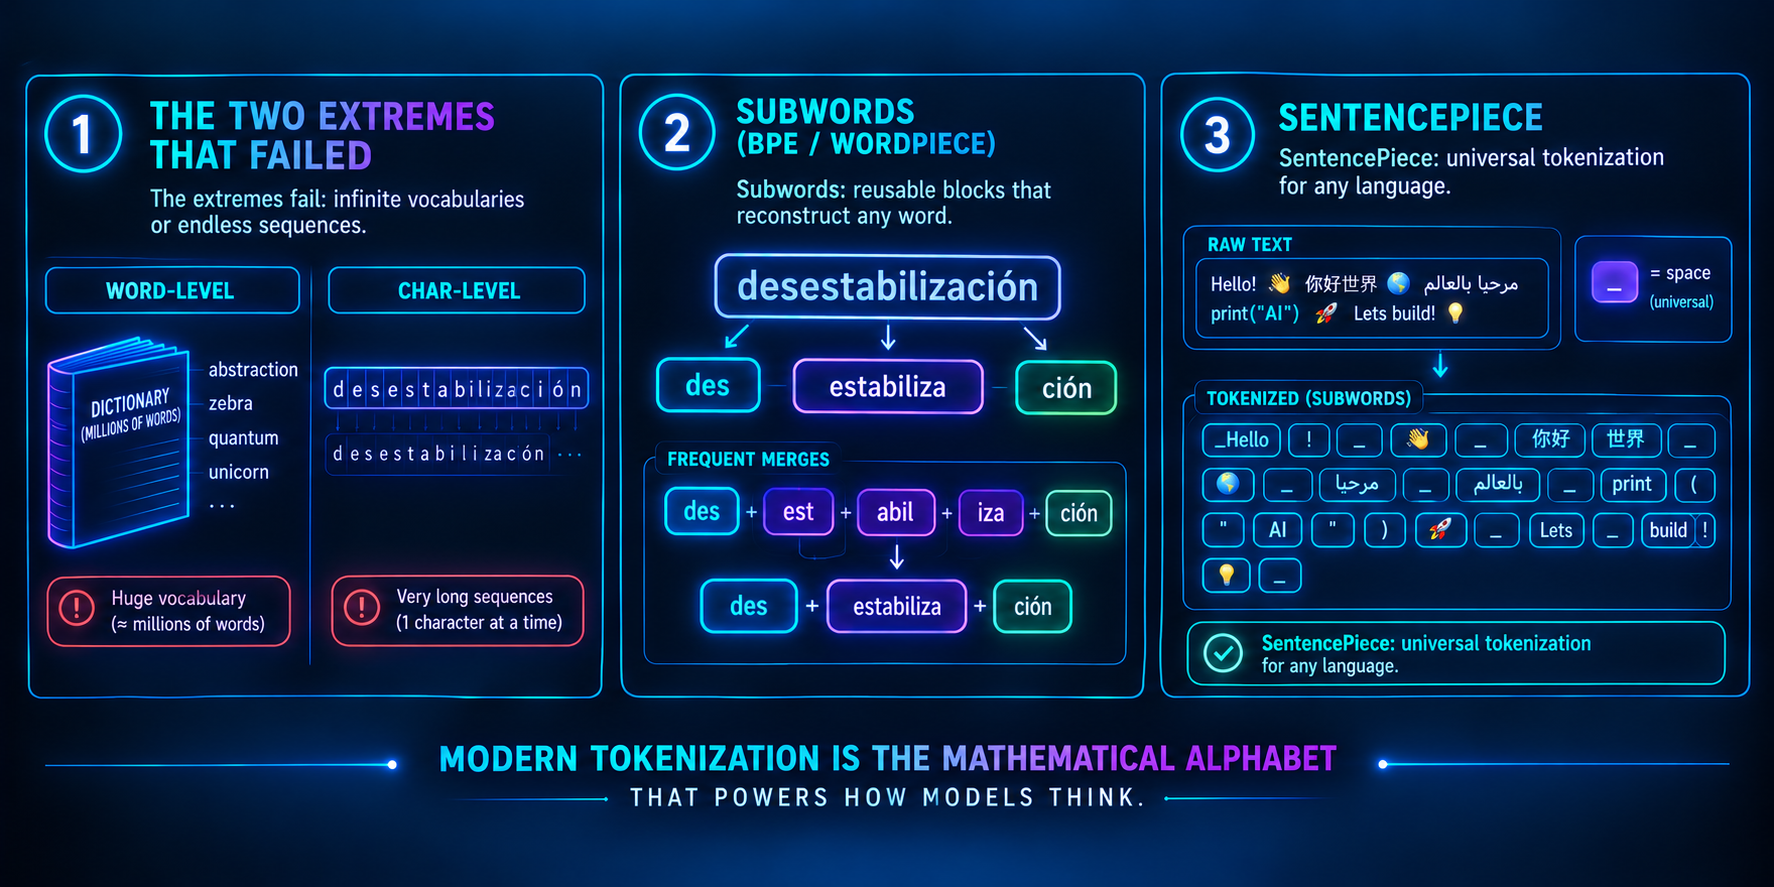
1. El dilema clásico: los dos extremos que chocaron con la realidad
Para trocear un texto, la intuición nos empuja hacia dos opciones evidentes: ir palabra por palabra, o letra por letra. Ambas tienen trampas mortales.

Enfoque 1: por palabras completas (Word-level)
Parecía lo más natural del mundo: separar por espacios y asignar un número a cada palabra del diccionario.
- El desastre: el lenguaje humano no tiene fin. Hay plurales, conjugaciones, diminutivos, regionalismos, erratas («ola ke ase») y neologismos que nacen cada día («metaverso», «tiktoker», «prompting»).
- El resultado: vocabularios gigantescos de millones de términos que disparan el consumo de memoria y ralentizan todo. Y lo peor: si el usuario escribe una palabra que no estaba en la lista fija, el modelo se queda completamente ciego y escupe el temido token
[UNK](Unknown, desconocido).
Enfoque 2: por caracteres individuales (Char-level)
La solución opuesta: que cada letra o signo de puntuación sea un token.
- La ventaja: el vocabulario es enano (apenas unas decenas de símbolos) y nunca hay palabras desconocidas.
- El desastre: las frases se vuelven ridículamente largas. Observa cómo se disparan los tokens:
- «transformers» → 12 tokens
- «transformadores» → 15 tokens
- «anticonstitucionalmente» → 23 tokens
Como los Transformers tienen un límite estricto de memoria contextual, gastarías la mitad de su capacidad simplemente deletreando unas pocas frases antes de poder razonar sobre ellas.
La conclusión fue evidente: hacía falta un punto intermedio. Ni palabras enteras, ni letras sueltas. Algo más flexible, más compacto y más inteligente.
2. La revolución: la tokenización por subpalabras (subwords)
La idea que lo cambió todo fue partir el lenguaje en fragmentos recurrentes: piezas que aparecen una y otra vez en muchas palabras distintas.
La solución: trocear las palabras en subwords frecuentes.
La analogía de las piezas de LEGO. En lugar de fabricar un juguete prearmado para cada objeto del universo (palabras completas) o darte únicamente átomos sueltos de plástico (caracteres), te entregan un juego inteligente de bloques medianos: prefijos, raíces y sufijos comunes.
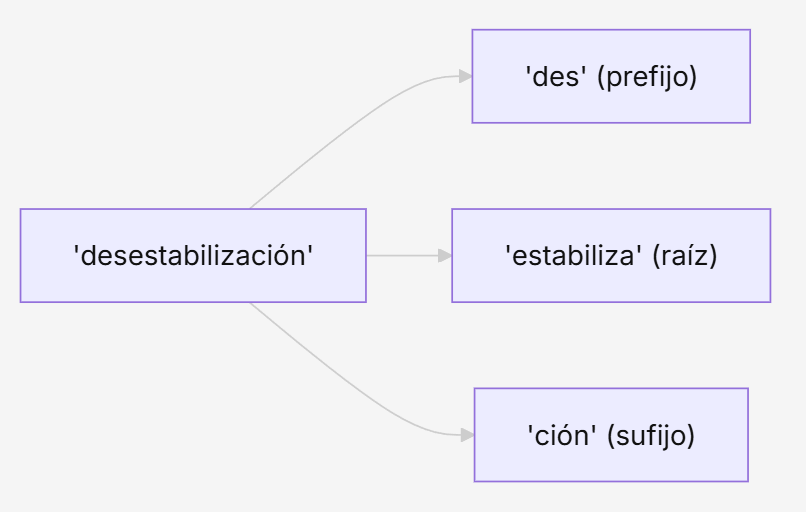
Mira lo natural que resulta:
- «transformación» →
"trans"+"forma"+"ción" - «imposible» →
"im"+"posible"
Si aparece una palabra jamás vista durante el entrenamiento, el modelo no entra en pánico ni se queda a oscuras: la reconstruye en vivo combinando piezas que ya conoce.
3. BPE (Byte-Pair Encoding): el artesano que fusiona piezas
BPE es el algoritmo que conquistó el procesamiento del lenguaje moderno (lo usan desde GPT-2 hasta modelos actuales). Lo curioso es que nació en los años noventa como un simple algoritmo de compresión de datos… y resultó ser la herramienta perfecta para el texto.
¿Cómo funciona el entrenamiento de BPE?
- Punto de partida: empieza considerando cada carácter como un token independiente.
- Conteo: examina millones de textos buscando qué pareja de tokens contiguos aparece junta con más frecuencia.
- Fusión (merge): une esa pareja ganadora para crear un token nuevo y lo añade a su vocabulario.
- Repetición: repite el ciclo miles de veces, hasta alcanzar el tamaño de vocabulario fijado (por ejemplo, 50.000 tokens).
Un ejemplo paso a paso
Imagina un corpus donde se repiten mucho las palabras «transformar», «transformación» y «transformers». BPE irá fusionando por frecuencia:

Al final del proceso, el algoritmo ha aprendido —de forma puramente estadística, sin saber nada de gramática humana— que"trans"y"form"son unidades de significado muy potentes, y las deja como bloques sólidos. Es un artesano que construye el idioma desde abajo, soldando las piezas que más veces ve juntas.
4. WordPiece vs. BPE: dos formas de pensar
Modelos históricos como BERT introdujeron una variante llamada WordPiece. El objetivo es idéntico (crear subwords), pero su filosofía para decidir qué piezas unir es distinta:
| Característica | BPE (Byte-Pair Encoding) | WordPiece (BERT) |
|---|---|---|
| Criterio de unión | Frecuencia bruta (las dos piezas que más coinciden). | Probabilidad estadística (máxima verosimilitud del corpus). |
| Pregunta clave | «¿Qué dos símbolos se repiten más juntos?» | «¿Unir estas dos piezas ayuda a predecir mejor el texto global?» |
| Estilo | Mecánico, directo y muy rápido. | Estadístico y matemáticamente más riguroso. |
| Identificación visual | Depende del sistema (Ġpara espacios en GPT). |
Usa prefijos dobles (ej.:trans,##forma,##ción). |
En resumen: BPE es el fusionador mecánico; WordPiece es su primo académico, que en lugar de contar coincidencias calcula qué unión hace el texto más predecible.
5. SentencePiece: el estándar multilingüe definitivo
A pesar del éxito de BPE, los tokenizadores clásicos arrastraban un vicio muy occidental: daban por hecho que las palabras siempre vienen separadas por espacios en blanco.
Eso funciona en español o inglés, pero se rompe por completo con idiomas como el chino o el japonés, donde no existen espacios entre palabras:
En 2018, Google lanzó SentencePiece, la pieza de ingeniería que utilizan hoy Llama, T5, PaLI y Gemini, entre muchos otros modelos multilingües.
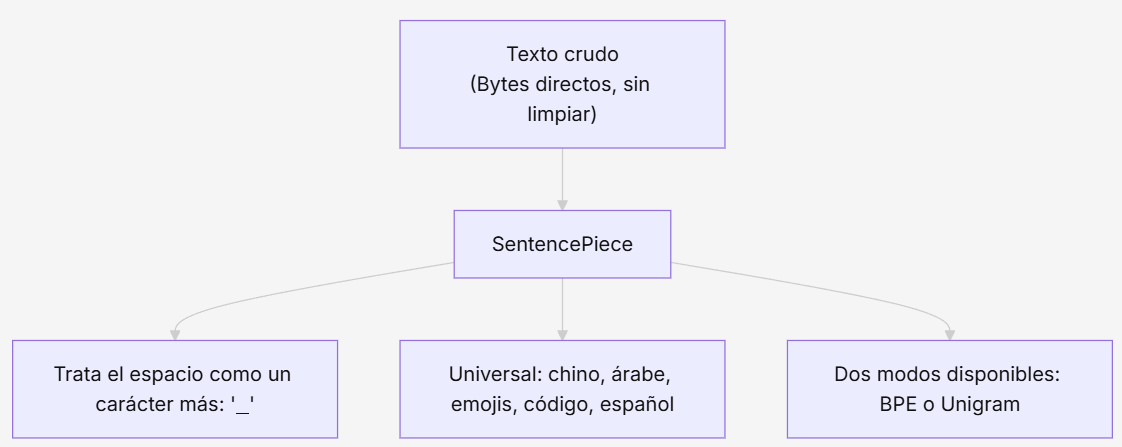
Sus saltos clave
- Trata el texto como una secuencia cruda de bytes: no necesita que limpies nada de antemano. Admite emojis 🚀, símbolos matemáticos, código, hashtags y URLs rotas sin pestañear.
- El espacio es un carácter visible: sustituye los espacios por un símbolo especial (habitualmente
▁). Esto permite des-tokenizar —reconstruir el texto original— de forma exacta y reversible, sin perder ni una coma ni un salto de línea. - Multilingüismo real: procesa alfabetos no latinos y lenguas sin separación de palabras con la misma soltura que el inglés.
- Flexible: puede operar en modo BPE o en modo Unigram, según lo que convenga al modelo.
Es, en la práctica, el tokenizador más robusto del mundo real.
6. Comparativa real: el viaje de una palabra compleja
Observa cómo procesa cada enfoque una palabra técnica e inusual como «anticonstitucionalmente»:
| Enfoque | Resultado del troceado | Nº de tokens | Impacto en el modelo |
|---|---|---|---|
| Por palabras (Word-level) | [UNK] |
1 | Ciego: no sabe qué significa; pierde toda la información. |
| Por caracteres (Char-level) | ['a','n','t','i','c','o', ...] |
23 | Ahogado: consume una barbaridad de la ventana de contexto. |
| BPE clásico | ['anti', 'constitucional', 'mente'] |
3 | Óptimo: reconoce prefijo, raíz y sufijo de forma natural. |
| SentencePiece | ['▁anti', 'constitu', 'cional', 'mente'] |
4 | Robusto: conserva el espacio previo y entiende la estructura sin esfuerzo. |
El modelo comprende el significado de la palabra compuesta sin haberla visto nunca entera durante su entrenamiento.
7. ¿Por qué la tokenización importa tanto (y toca tu bolsillo)?
La tokenización no es un debate técnico de laboratorio: tiene consecuencias económicas y de rendimiento directas.
- Coste de inferencia (las facturas de las API): OpenAI, Anthropic y Google no cobran por palabras ni por letras; cobran por millón de tokens. Si un mal tokenizador parte un texto en 1.500 tokens en lugar de 1.000, estás pagando un 50% más por procesar exactamente la misma información.
- La «tasa no inglesa» (language bias): históricamente, los vocabularios de los LLM estaban saturados de subpalabras en inglés. Mientras una palabra inglesa costaba 1 token, su traducción al español o al alemán requería 2 o 3, y en árabe o hindi podía dispararse a 6 tokens por palabra. Los tokenizadores modernos con vocabularios grandes (los 128k tokens de Llama 3 o GPT-4o) han corregido esa brecha, abaratando el uso en otros idiomas.
- Capacidad de contexto: tu modelo tiene un límite de atención (8k, 32k, 128k tokens…). Un tokenizador eficiente comprime mejor el texto, lo que permite meter libros más largos o códigos más densos en el mismo espacio.
- Calidad del modelo: los embeddings dependen por completo del tokenizador. Cambiarlo a mitad de camino destruye el espacio semántico que el modelo había aprendido con tanto esfuerzo.
En resumen
La tokenización moderna resolvió el enigma fundacional de cómo hacer que las máquinas interpreten nuestro lenguaje:
- Descartó los extremos: superó la ceguera de las palabras completas y la lentitud asfixiante de los caracteres sueltos.
- Adoptó las subpalabras: construyó vocabularios flexibles con piezas de LEGO reutilizables, capaces de reconstruir cualquier palabra nueva.
- BPE aprendió a fusionar: encuentra las raíces y patrones más comunes basándose en la frecuencia estadística de los textos.
- SentencePiece eliminó las fronteras: llevó la tokenización al nivel de bytes, funcionando de forma transparente con cualquier idioma del planeta, código o emojis.
- Dicta la eficiencia: define cuánto contexto cabe en la memoria y cuánto cuesta ejecutar el modelo.
Fue el momento exacto en el que las máquinas dejaron de leer el texto como una sopa de letras caótica… y empezaron a construir con él las piezas del significado.