

Multimodalidad — CLIP: cuando la IA aprendió a entender imágenes y texto en el mismo idioma
El puente que unificó visión y lenguaje y dio origen a la IA moderna
Embeddings conjuntos, espacios latentes compartidos y el motor conceptual detrás de Stable Diffusion, Midjourney, GPT-4o Vision y Gemini.
Durante años, la inteligencia artificial vivió partida en dos continentes que parecían condenados a no entenderse jamás:
- El mundo del lenguaje: gobernado por secuencias, atención y Transformers.
- El mundo de la visión: gobernado primero por las convoluciones (CNN) y, más tarde, por los Vision Transformers (ViT).
Eran dos universos que hablaban idiomas incompatibles. Uno pensaba en cadenas de palabras; el otro, en cuadrículas de píxeles. Una máquina podía redactar un ensayo brillante sobre astronomía o clasificar fotos de galaxias, pero no existía un puente elegante que conectara el significado de ambos mundos. Si querías que un modelo reconociera una foto, estabas atado a etiquetas rígidas y predefinidas (como las 1.000 clases fijas de ImageNet): si aparecía un objeto nuevo, la red se quedaba muda.
Todo cambió a principios de 2021, cuando OpenAI presentó un modelo que parecía casi demasiado simple… pero que reescribió la historia:
CLIP — Contrastive Language–Image Pretraining.
Conviene aclarar enseguida qué no es CLIP, porque ahí vive casi toda la confusión:
- No genera imágenes (eso lo hace un modelo de difusión).
- No responde preguntas como un chatbot.
- No es un clasificador tradicional de casillas cerradas.
CLIP es algo más profundo y más humilde: el traductor universal entre la vista y la palabra. El «Google Translate» que faltaba entre píxeles y letras.
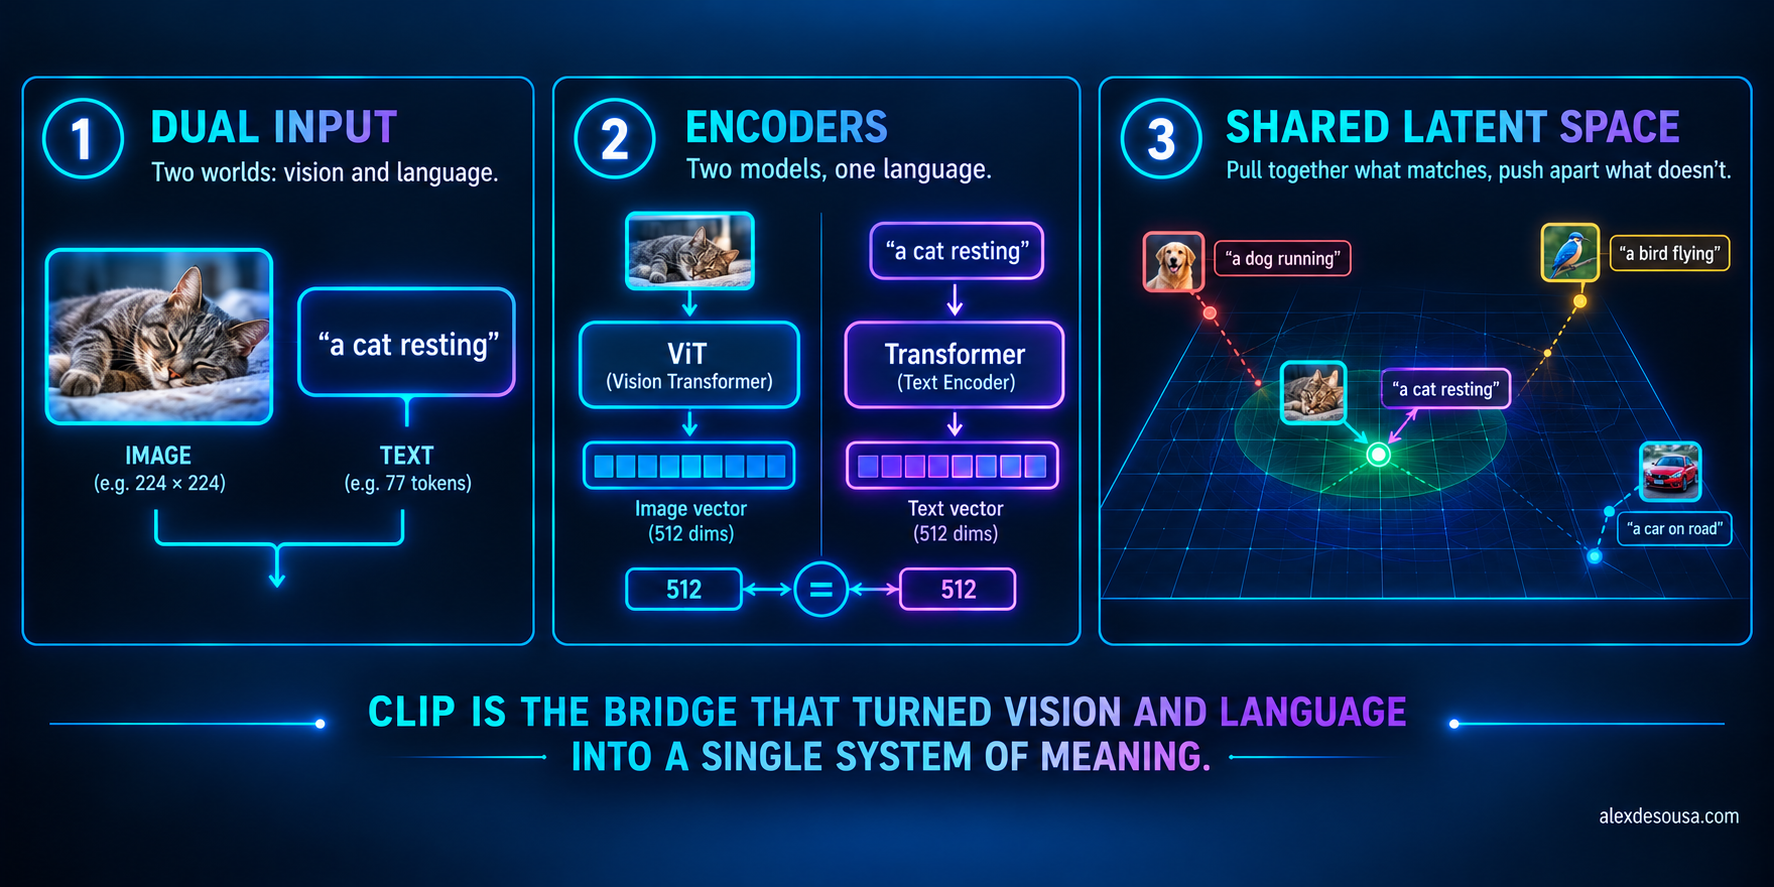
1. La idea fundacional: un único mapa para dos mundos
Antes de CLIP, cada tipo de modelo dibujaba su propio mapa. Los modelos de visión colocaban las imágenes en un espacio matemático; los de lenguaje colocaban las palabras en otro mapa totalmente aislado. Eran dos atlas distintos, sin ninguna ciudad en común.
CLIP partió de una hipótesis tan intuitiva como demoledora:
Si la foto de un gato dormido y la frase escrita
"a cat resting"describen exactamente lo mismo en la realidad… deberían aterrizar en las mismas coordenadas matemáticas.
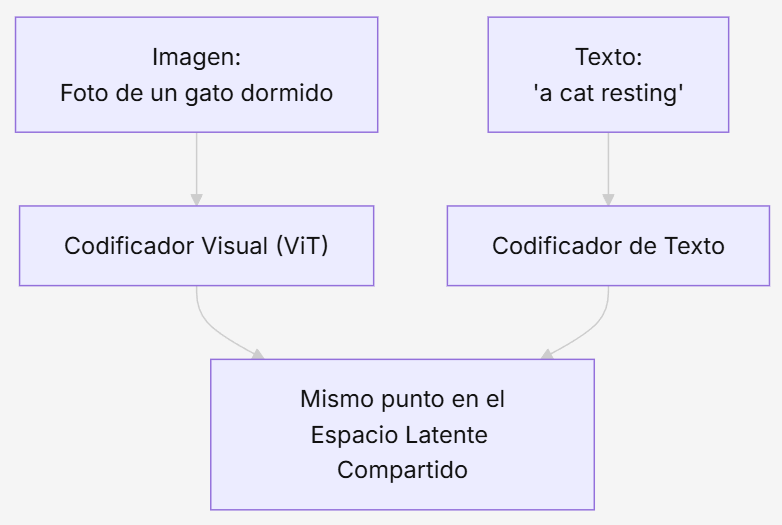
A ese punto de encuentro lo llamamos espacio latente compartido. Da igual si la entrada son píxeles o caracteres: si el concepto es el mismo, el vector resultante debe caer en el mismo lugar. Ese único mapa común es la semilla de toda la multimodalidad moderna.
2. Dos modelos especializados, una sola partitura
Para lograrlo, CLIP no inventó nada desde cero: unió las dos arquitecturas que ya dominaban cada mundo y las obligó a tocar la misma canción.
- Un Vision Transformer (ViT): toma la imagen, la trocea en parches y la convierte en un vector visual.
- Un Transformer de texto estándar: toma una frase, calcula sus embeddings contextuales con atención y la convierte en un vector textual.
El detalle crucial: ambos proyectan su resultado en un espacio geométrico con el mismo número de dimensiones (por ejemplo, vectores de 512 o 768 números). Sin esa condición, comparar una imagen con un texto sería como intentar sumar peras con kilómetros.
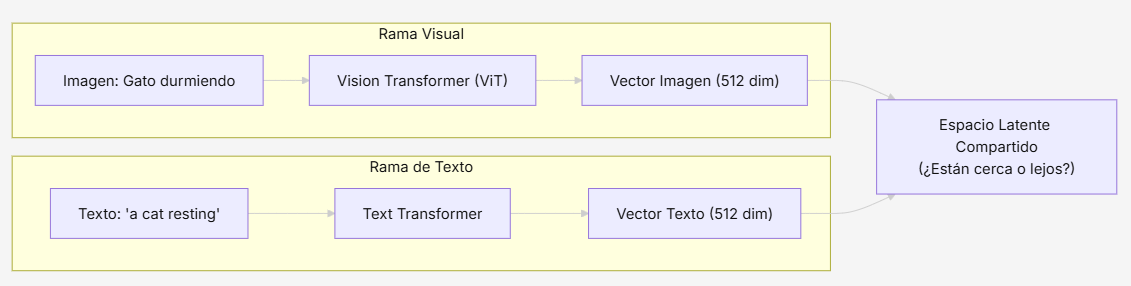
Pero la verdadera magia no está en los codificadores, sino en cómo se entrenan juntos: el aprendizaje contrastivo (contrastive learning).
3. El truco del aprendizaje contrastivo masivo
¿Cómo convences a dos redes neuronales que nacieron por separado de que hablen el mismo dialecto matemático?
OpenAI recopiló de internet un catálogo colosal: 400 millones de pares imagen-texto (fotos reales acompañadas de las descripciones que ya tenían asociadas en la web).
Durante el entrenamiento, al modelo se le presenta un lote (batch) enorme; por ejemplo, 32.768 imágenes junto a sus 32.768 textos correspondientes. Y entonces se aplican dos fuerzas opuestas al mismo tiempo:
- Fuerza de atracción: el vector de la imagen 1 debe acercarse todo lo posible al texto 1 (su pareja correcta).
- Fuerza de repulsión: esa misma imagen 1 debe alejarse al máximo de los otros 32.767 textos del lote que no le corresponden.
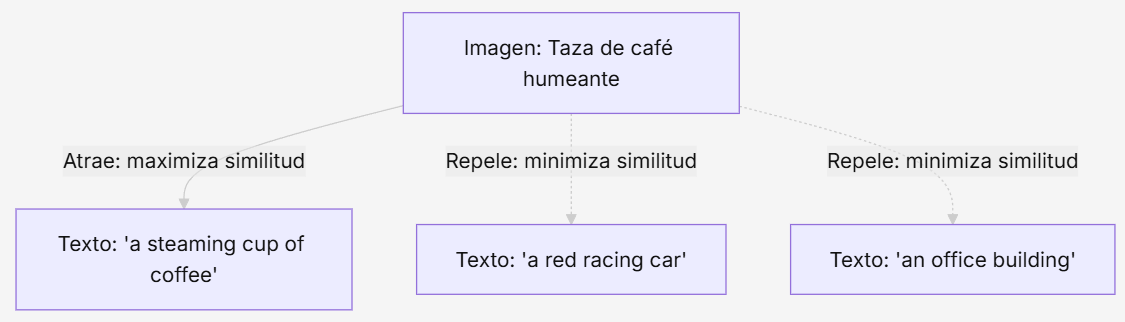
Es como someter a la red al juego de emparejar cartas millones de veces seguidas. El modelo no ajusta sus parámetros para memorizar píxeles concretos, sino para entender la correspondencia semántica entre lo que se ve y lo que se lee. Aprende relaciones, no recetas.
4. El fin de las etiquetas fijas: la clasificación «Zero-Shot»
Aquí está una de las consecuencias más espectaculares. Antes de CLIP, clasificar imágenes era un proceso rígido y caro. Si entrenabas un modelo para distinguir gatos de perros y al día siguiente necesitabas detectar un «dron submarino experimental», el modelo fallaba sin remedio: tocaba conseguir miles de fotos nuevas, etiquetarlas a mano y reentrenar toda la red.
CLIP demolió ese muro con la clasificación zero-shot (clasificar sin haber sido entrenado específicamente para esa tarea).
| Enfoque clásico (tipo ImageNet) | Enfoque CLIP (Zero-Shot) |
|---|---|
| Clases fijas (ej. Clase 42 = «Perro») | Vocabulario infinito en lenguaje natural |
| Requiere miles de fotos etiquetadas por categoría | Solo requiere escribir una frase descriptiva |
| Si aparece un objeto nuevo, hay que reentrenar | Si el concepto se puede redactar, se puede reconocer |
¿Cómo clasifica CLIP algo que nunca le enseñaron?
- Tomas la foto de un animal misterioso.
- Escribes varias opciones en texto plano, usando plantillas (prompts):
"a photo of a cheetah""a photo of a leopard""a photo of a jaguar"
- Pasas la foto por el codificador visual y cada frase por el codificador de texto.
- Calculas la similitud coseno (básicamente, el ángulo geométrico) entre el vector de la imagen y el de cada frase.
- La frase cuyo vector quede más cerca de la imagen gana la partida.
CLIP puede reconocer conceptos que jamás vio agrupados de forma explícita, porque durante su entrenamiento no aprendió casillas cerradas, sino conceptos generales del mundo.
5. El lenguaje como compresor semántico supremo
¿Por qué funciona tan bien algo aparentemente tan simple? Porque el lenguaje humano es el sistema de compresión de información más potente que existe. Fíjate en esta frase:
«a small dog running on a snowy hill at sunset»
(un perrito corriendo por una colina nevada al atardecer)
En apenas 10 palabras quedan comprimidos de golpe:
- Sujeto: un perro, y además pequeño.
- Acción dinámica: correr.
- Entorno y terreno: una colina cubierta de nieve.
- Momento e iluminación: luz dorada y rasante propia del atardecer.
- Composición e intención implícitas en toda la escena.
Al obligar a la red de visión a proyectar la imagen en el mismo punto exacto que ese resumen de texto, fuerzas al modelo visual a captar no solo bordes y colores, sino la narrativa completa de la escena. El texto actúa como un profesor que le resume a la vista qué es lo verdaderamente importante de cada foto.
6. El impacto real: la chispa que encendió la IA moderna
CLIP no fue un modelo más en un laboratorio: fue la pieza que desatascó varias de las tecnologías más disruptivas de hoy.
1. La revolución generativa (Stable Diffusion, Midjourney, DALL·E)
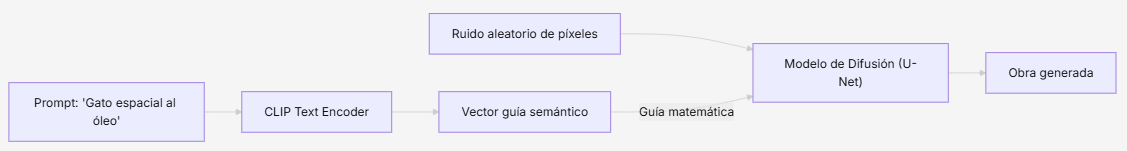
Un modelo de difusión solo sabe transformar ruido caótico en formas nítidas, pero por sí solo es sordo: no tiene ni idea de qué significa «un astronauta a caballo en Marte». CLIP es el director de orquesta: traduce el prompt del usuario en un vector guía dentro del espacio latente, y el modelo de difusión va esculpiendo los píxeles hasta que su vector visual coincide con ese vector de texto.
2. Búsqueda semántica visual sin etiquetas
Los buscadores de fotos modernos (Google Fotos, Apple Photos) te dejan escribir «el día que se cayó la tarta» y encontrar la imagen exacta, sin que nadie hubiera etiquetado antes ese archivo. Buscan vectores cercanos en el espacio latente compartido.
3. Modelos multimodales de frontera (GPT-4o Vision, Gemini, PaLI, Flamingo)
Los grandes modelos conversacionales de hoy ya no son procesadores de texto con un módulo de visión pegado como parche: sus espacios de representación unifican tokens de texto con parches de imagen (e incluso espectrogramas de audio) bajo el mismo principio que inauguró CLIP.
7. CLIP en el mundo productivo
Más allá de los titulares, CLIP es el motor silencioso detrás de muchísimas aplicaciones cotidianas: buscadores visuales inteligentes, sistemas de etiquetado automático en e-commerce (que clasifican millones de prendas por estilo, color y temporada sin intervención humana), filtros de moderación de contenido (que detectan material inapropiado comparando imágenes con descripciones prohibidas), asistentes multimodales, análisis de documentos con imágenes, y robots industriales capaces de interpretar órdenes como «recoge la herramienta oxidada de la mesa» identificando visualmente el objeto descrito.
En todos esos casos hace lo mismo: traducir entre lo que se ve y lo que se dice.
En resumen
- Durante años, la visión y el lenguaje operaron en universos matemáticos separados, sin un puente entre ellos.
- CLIP los unificó proyectando imágenes y frases en un espacio latente compartido.
- Se entrena mediante aprendizaje contrastivo masivo (400 millones de pares): acercar los vectores que coinciden, alejar los que no.
- Habilitó la clasificación zero-shot, despidiéndose para siempre de la dependencia de clases fijas.
- Se convirtió en el motor semántico imprescindible de los generadores de imágenes como Stable Diffusion y Midjourney.
- Es la base conceptual de la multimodalidad actual (GPT-4o Vision, Gemini, PaLI, Flamingo).
- Demostró que el lenguaje es la herramienta más eficaz para enseñar a una máquina a comprender el contenido de una imagen.
Fue el momento exacto en el que la inteligencia artificial dejó de ver las fotos como frías cuadrículas de números… y empezó a interpretarlas como ideas.