

CNN: la arquitectura que enseñó a las máquinas a ver
Convolución, padding, stride, pooling, arquitecturas y transfer learning
Cómo las redes neuronales aprenden patrones visuales y por qué revolucionaron la visión por computadora.
Hasta ahora hemos vivido en el universo del lenguaje: redes recurrentes, puertas de memoria, atención, Transformers, embeddings y LLMs.
Pero la inteligencia artificial moderna no solo lee y escribe: también tiene ojos.
Mucho antes de que los Vision Transformers irrumpieran en escena, la visión por computadora se cimentó sobre una familia de arquitecturas que cambió las reglas del juego: las Convolutional Neural Networks (CNN), o redes neuronales convolucionales.
Las CNN fueron al mundo visual lo que los Transformers al texto: el salto definitivo que permitió a las máquinas pasar de analizar números inconexos a reconocer caras, leer radiografías, guiar coches autónomos y entender la realidad en imágenes.
Veamos, paso a paso, cómo lograron semejante hazaña.
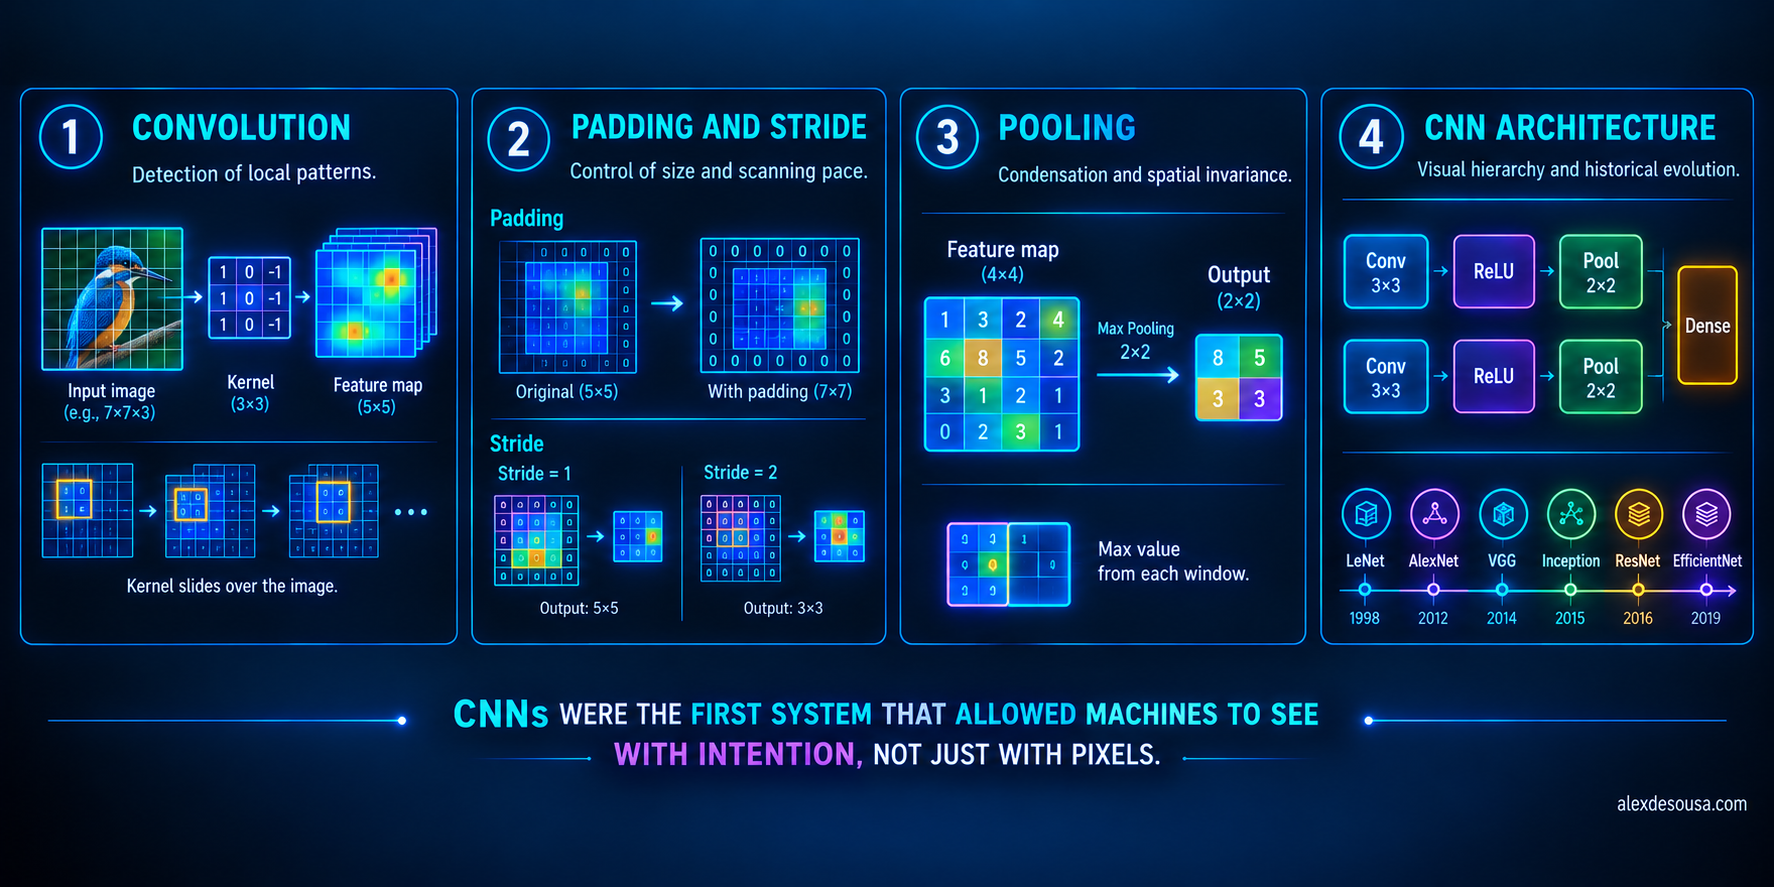
1. ¿Qué es una CNN y por qué fallaban las redes tradicionales?
Para entender su genialidad, primero hay que entender el desastre que suponía usar redes densas (feed-forward) clásicas con imágenes.
Imagina una fotografía a color modesta: 1000 × 1000 píxeles con 3 canales (Rojo, Verde y Azul). Eso son 3 millones de valores de entrada. Si la conectas a una capa oculta clásica de apenas 1000 neuronas, necesitas 3.000 millones de parámetros solo en el primer paso. La red colapsaría por falta de memoria y caería en un sobreajuste salvaje.
Y hay un problema aún peor: una red densa trata cada píxel como una variable independiente. Si mueves un gato dos centímetros a la derecha en la foto, para la red es un enigma completamente nuevo que nunca había visto.
Las CNN dijeron basta y se apoyaron en un principio visual fundamental:
Los patrones visuales no habitan en píxeles aislados; habitan en regiones locales.
Una CNN no intenta tragarse la foto de golpe. Funciona igual que el córtex visual biológico: construye la comprensión del mundo de abajo hacia arriba, en una jerarquía natural.

2. Convolución: la linterna que escanea la imagen
La convolución es el corazón del sistema. En lugar de conectar todas las neuronas a todos los píxeles, la red usa una pequeña matriz numérica llamada filtro o kernel (normalmente de tamaño compacto, 3×3 o 5×5).
La analogía de la linterna. Imagina que estás a oscuras frente a un gran mural, con una linterna pequeña. No ves todo el mural a la vez: vas deslizando el haz de luz de izquierda a derecha y de arriba a abajo. Cada vez que la linterna enfoca una baldosa de 3×3 píxeles, el filtro multiplica sus números por los de la imagen, los suma y genera un único resultado.
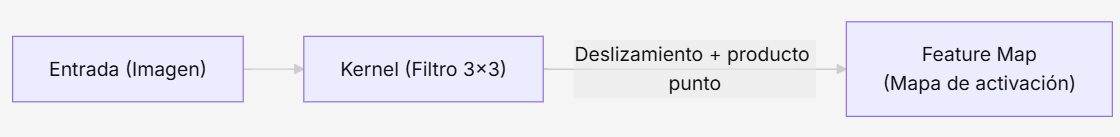
El resultado de ese barrido es un feature map (mapa de características): una nueva versión de la imagen que resalta únicamente aquello que el filtro buscaba (por ejemplo, dónde hay líneas verticales, curvas o reflejos de luz).
Y aquí está la clave: en una capa convolucional no hay un solo filtro, sino decenas o cientos en paralelo, cada uno especializado en «cazar» un rasgo visual distinto.
3. Padding: el salvavidas de los bordes
Al deslizar una ventana de 3×3 sobre una cuadrícula, aparecen enseguida dos problemas físicos:
- El centro del filtro no puede apoyarse en las esquinas extremas, así que la matriz de salida resulta más pequeña que la original.
- Los píxeles centrales se escanean muchas veces, pero los de los bordes apenas se tocan una vez.
Para resolverlo añadimos padding: un marco artificial (normalmente de ceros) alrededor de la imagen, como ponerle un paspartú a un cuadro.
| Tipo de padding | En qué consiste | Efecto en la imagen |
|---|---|---|
| Valid | Sin relleno; solo se calcula donde el filtro entra completo | La salida se reduce en cada capa |
| Same | Se añaden filas y columnas de ceros en los márgenes | La salida mantiene exactamente el mismo tamaño |
Gracias al padding, una red muy profunda puede apilar decenas de capas consecutivas sin encoger la imagen hasta hacerla desaparecer en los primeros pasos.
4. Stride: la zancada del filtro
El stride (o paso) determina cuántos píxeles salta el filtro en cada movimiento:
- Stride = 1: avanza píxel a píxel. Análisis exhaustivo, lento y detallado.
- Stride = 2: avanza de dos en dos casillas, reduciendo la imagen a la mitad.
- Stride > 2: saltos amplios y reducción drástica de la resolución.
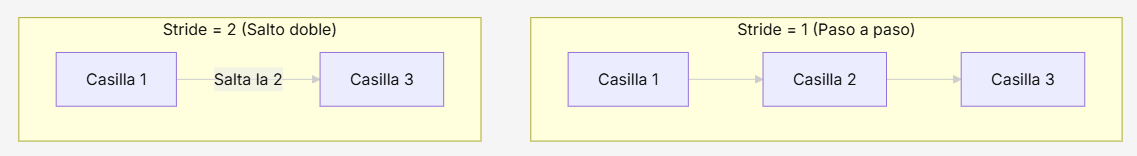
Aumentar el stride es una de las formas más eficientes de downsampling (reducir la dimensionalidad espacial) ahorrando cómputo.
5. Pooling: sintetizar sin perder lo fundamental
Si una capa detecta que en una esquina hay una oreja de gato, a las capas siguientes no les interesa la coordenada milimétrica exacta de cada píxel; les basta con saber: «hay una oreja en esta zona general».
Para eso sirve el pooling: condensa regiones contiguas, reduce el tamaño espacial y aporta invarianza a pequeñas traslaciones (si el gato se mueve dos píxeles, la red lo detecta igual).
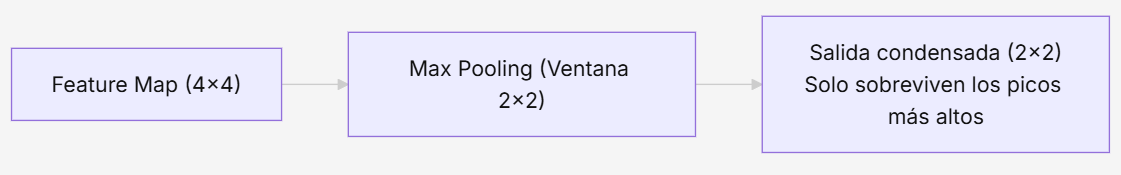
Hay dos sabores principales:
- Max pooling (el rey indiscutible): divide el mapa en cuadrículas (típicamente 2×2) y se queda solo con el número más alto. Conserva la activación más intensa y descarta el resto.
- Average pooling: extrae la media de cada cuadrícula, suavizando las activaciones.
En conjunto, el pooling aporta tres ventajas: tolerancia a pequeños movimientos, menos parámetros y un aprendizaje más estable.
6. Convoluciones 1×1: la compresión inteligente
A primera vista, un filtro de 1×1 parece absurdo: ¿qué forma geométrica vas a detectar mirando un único píxel?
La magia no está en el plano espacial, sino en la profundidad, es decir, en los canales. Si tienes un mapa con 256 canales (filtros acumulados), un filtro 1×1 actúa a lo largo de todo ese haz vertical.
La analogía del mezclador de pintura. Imagina que en cada punto de la imagen tienes 256 tubos de colores distintos. La convolución 1×1 mezcla esos 256 tonos en proporciones aprendidas y los resume, por ejemplo, en solo 64 canales, sin tocar la anchura ni la altura de la imagen.
Fue el arma secreta de arquitecturas legendarias como Inception, ResNet y MobileNet para:
- reducir la dimensionalidad antes de operaciones pesadas,
- fusionar información dispersa entre canales,
- y añadir no-linealidades (ReLU) a coste de cómputo mínimo.
7. El árbol genealógico: evolución de las grandes arquitecturas
La visión artificial moderna se puede contar a través de los hitos que marcaron cada salto competitivo.

| Arquitectura | Año | Gran innovación | Por qué pasó a la historia |
|---|---|---|---|
| LeNet-5 | 1998 | Convolución + pooling para reconocer dígitos (Yann LeCun) | Probó que la teoría convolucional funcionaba en el mundo real. |
| AlexNet | 2012 | Entrenamiento en GPUs, ReLU y Dropout | Aplastó a la competencia en ImageNet y encendió la era del Deep Learning. |
| VGG | 2014 | Filtros diminutos 3×3 apilados | Demostró que apilar filtros pequeños y profundizar supera a usar filtros grandes. |
| Inception | 2014 | Módulos multiescala en paralelo + filtros 1×1 | Procesaba varias escalas a la vez sin disparar los parámetros. |
| ResNet | 2015 | Conexiones residuales (skip connections) | Resolvió la degradación del gradiente y permitió entrenar redes de más de 150 capas. |
| EfficientNet | 2019 | Escalado compuesto (resolución + profundidad + anchura) | Máxima precisión equilibrando rendimiento y cómputo de forma científica. |
8. Transfer learning: la democratización de la visión
Entrenar una red como ResNet desde cero requiere semanas de cálculo y millones de fotografías etiquetadas (como el dataset ImageNet). Si eres una startup o un investigador independiente, ¿estás fuera del juego?
En absoluto, gracias al transfer learning (aprendizaje por transferencia).
Una CNN aprende de forma jerárquica:
- Sus capas iniciales detectan líneas, bordes, sombras y texturas universales, útiles por igual para distinguir un tumor, un coche o un muffin.
- Solo las últimas capas se especializan en la tarea concreta (por ejemplo, diferenciar razas de perros).
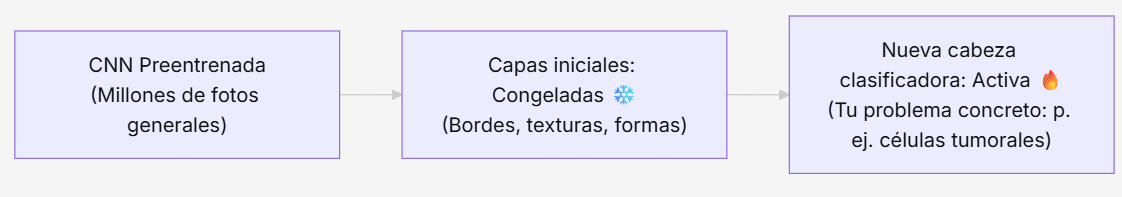
Basta con congelar el tronco de la red preentrenada, sustituir la última capa por una adecuada a tu objetivo y entrenar solo esa parte final con unos pocos cientos de fotos. Esta técnica es el motivo real por el que la visión por computadora saltó tan rápido de los laboratorios a las aplicaciones cotidianas, al alcance de startups, investigadores, empresas y desarrolladores individuales.
9. Los tres pilares del éxito de las CNN
Durante una década entera, ninguna otra técnica pudo hacerles sombra. El secreto de su hegemonía se resume en tres principios:
- Localidad espacial: asumen que los píxeles cercanos guardan una relación mucho más fuerte que los lejanos.
- Compartición de pesos (weight sharing): el mismo filtro detector de bordes se reutiliza por toda la imagen. Si el modelo aprende a detectar un ojo arriba a la izquierda, ese mismo filtro vale si el ojo aparece abajo a la derecha. Esto reduce los parámetros en órdenes de magnitud y mejora la generalización.
- Jerarquía composicional: ensamblan primitivas geométricas simples hasta convertirlas, de forma automática, en conceptos semánticos abstractos de alto nivel.
10. El relevo generacional: Vision Transformers (ViT)
Hoy el trono de la visión ya no es territorio exclusivo de las CNN. Los Vision Transformers (ViT) han demostrado que, con suficientes datos y cómputo, el mecanismo de atención pura puede fragmentar una imagen en pequeños parches (como si fueran palabras de un texto) y encontrar relaciones globales directas, sin depender de la ventana local de la convolución.
Aun así, el legado sigue muy vivo:
- Muchos modelos de producción modernos son híbridos: usan bloques convolucionales al principio para extraer texturas rápidas y atención después para contextualizar.
- En dispositivos móviles y entornos con pocos recursos, las CNN siguen siendo las reinas por velocidad y ligereza.
- Y para entender los ViT, es imprescindible dominar primero la intuición geométrica que las CNN nos enseñaron.
En resumen
- Las CNN rompieron el problema de la dimensionalidad visual procesando imágenes por regiones en lugar de píxel a píxel.
- La convolución actúa como un escáner de patrones característicos.
- El padding y el stride controlan el tamaño y el ritmo con el que se examina la imagen.
- El pooling condensa la información relevante y aporta tolerancia a pequeños movimientos.
- Las convoluciones 1×1 mezclan y comprimen canales sin distorsionar la resolución espacial.
- El transfer learning convirtió la visión artificial en una herramienta accesible para cualquier programador.
Las CNN marcaron el instante exacto en el que las máquinas dejaron de almacenar mapas ciegos de colores… y empezaron a interpretar el mundo con sus propios ojos.