

Embeddings contextuales
Cómo los modelos aprenden significado y por qué los Transformers cambiaron la forma de representar el lenguaje
De vectores estáticos a representaciones dinámicas que entienden el contexto.
Hasta ahora hemos recorrido toda la maquinaria: las RNN que intentaban recordar, las puertas de las LSTM/GRU, el mecanismo de atención y, por fin, los Transformers que lo procesan todo en paralelo.
Pero hay una pregunta fundacional que llevamos capítulos esquivando, y es la más básica de todas:
¿Cómo convierte una máquina el lenguaje en matemáticas sin tirar a la basura su significado?
Antes de que un Transformer pueda atender, comparar, generar o razonar, necesita traducir cada palabra a números. Ahí es donde entran los embeddings, y sobre todo el salto que lo cambió todo: los embeddings contextuales.
¿Qué es un embedding? La geometría del significado
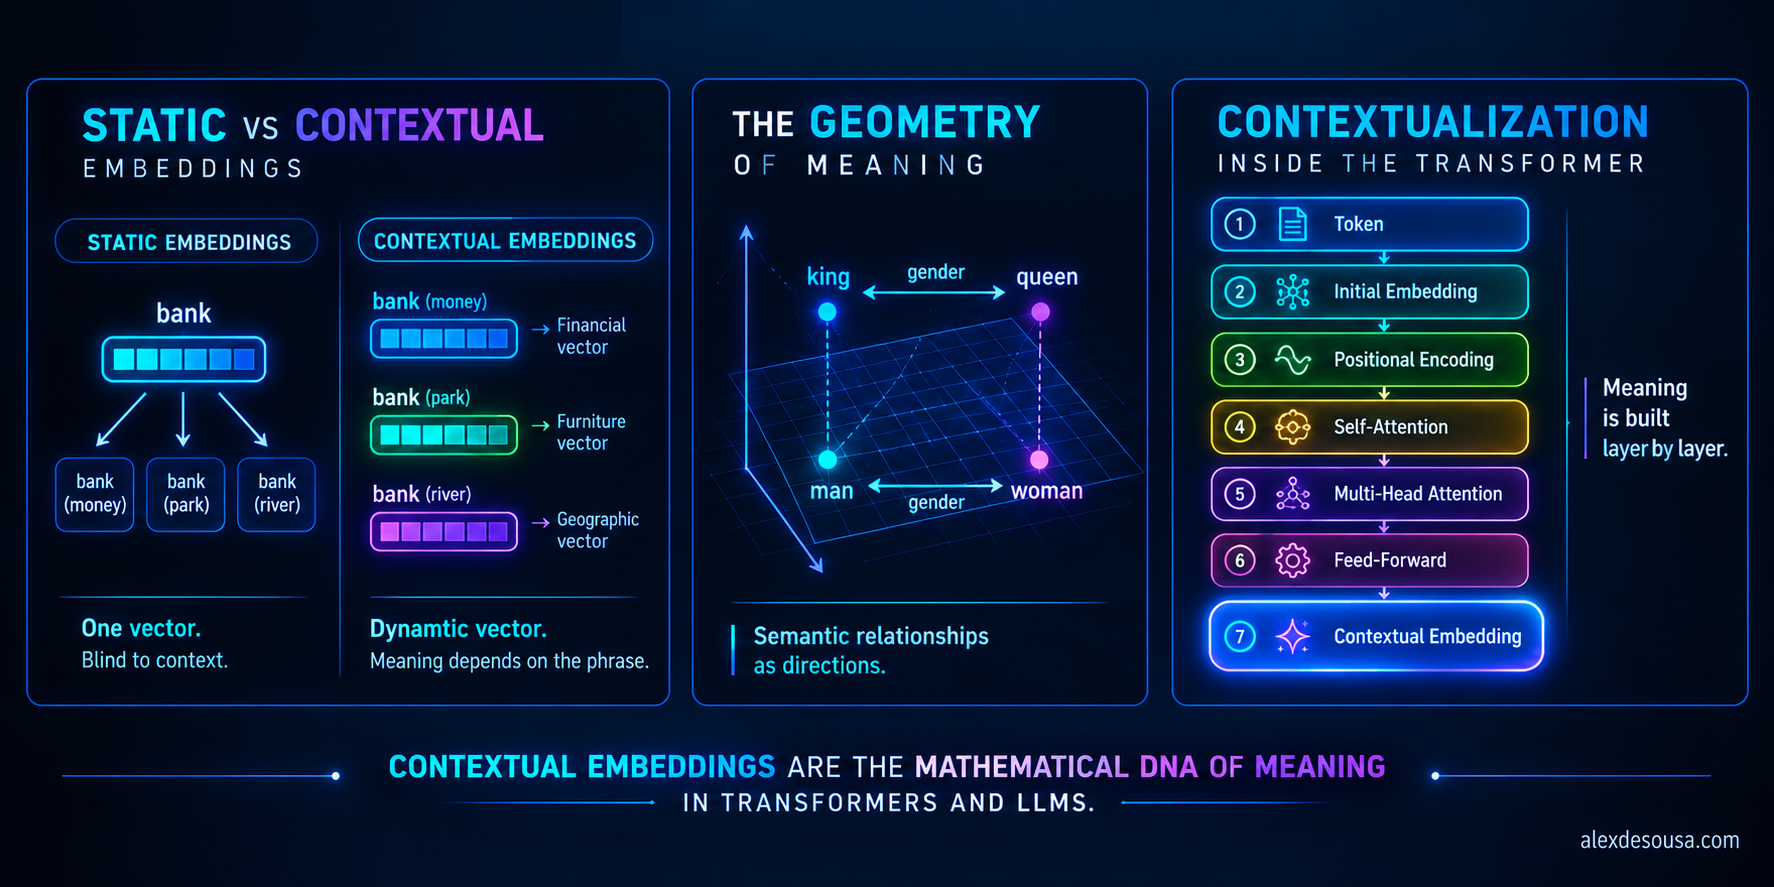
Un embedding es un vector: una lista de números (normalmente de cientos o miles de posiciones) que representa el significado de una palabra, una frase o un documento entero.
Pero no es una lista cualquiera, ni un simple código. Es un mapa geométrico del lenguaje.
La analogía del mapa de ciudades. Imagina un mapa gigante donde cada palabra es una ciudad. Las ciudades con «clima» parecido quedan cerca unas de otras: perro y gato son casi vecinas; perro y microchip están en continentes distintos. Y lo más fascinante: las distancias y direcciones tienen significado propio. La flecha que va de hombre a mujer apunta exactamente en la misma dirección que la que va de rey a reina.
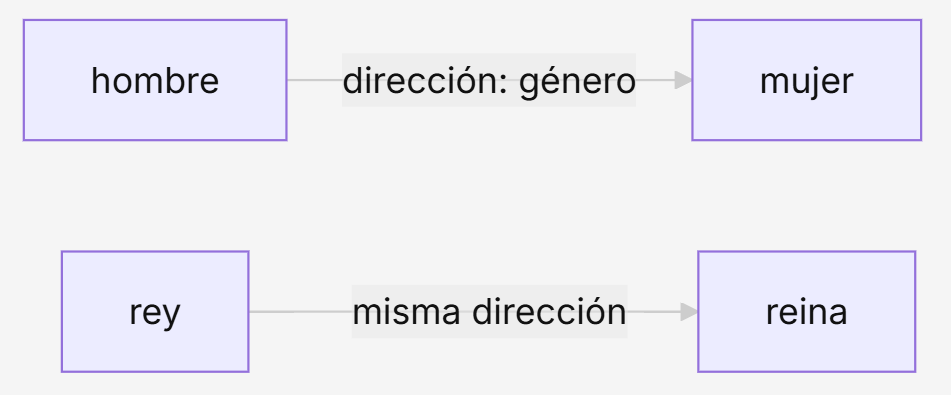
No es magia ni truco: es geometría semántica bien calibrada. Restas «masculinidad», sumas «feminidad», y te desplazas al punto correcto del mapa.
Embeddings estáticos: Word2Vec, GloVe y FastText
Antes de los Transformers, los embeddings tenían un pecado original: eran estáticos.
Una palabra = un único vector. Siempre. Sin importar la frase.
Piensa en la palabra «banco»:
- «Deposité mis ahorros en el banco.»
- «Me senté en el banco de la plaza.»
- «Un banco de peces cruzó el arrecife.»
En un modelo estático, banco tiene exactamente las mismas coordenadas en los tres casos. Su vector es una media forzada de todos sus usos: una mezcla difusa de finanzas, mobiliario y biología marina. El modelo era incapaz de desambiguar porque consultaba un diccionario fijo, no la situación real.
| Modelo estático | Cómo aprendía | Limitación clave |
|---|---|---|
| Word2Vec | Palabras que aparecen en contextos parecidos tienen significados parecidos | Un vector por palabra para todo el corpus |
| GloVe | Estadísticas globales de coocurrencia | Fijo; ciego a la polisemia |
| FastText | Trozos de palabra (subwords) | Maneja erratas y palabras raras, pero sigue siendo estático |
Fueron avances enormes, los cimientos de todo lo que vino después. Pero chocaban contra el mismo muro: no sabían leer la frase.
El gran salto: embeddings contextuales
Los Transformers trajeron una idea radical y, en el fondo, muy humana:
El significado de una palabra no vive en su entrada de diccionario; emerge de las palabras que la rodean.
Por tanto, el embedding no puede estar precocinado: hay que fabricarlo en vivo, cada vez.
Ahora «bank» en «I deposited money at the bank» y «bank» en «The fisherman sat by the river bank» tienen vectores completamente distintos. El modelo ya no memoriza significados: los construye en tiempo real.
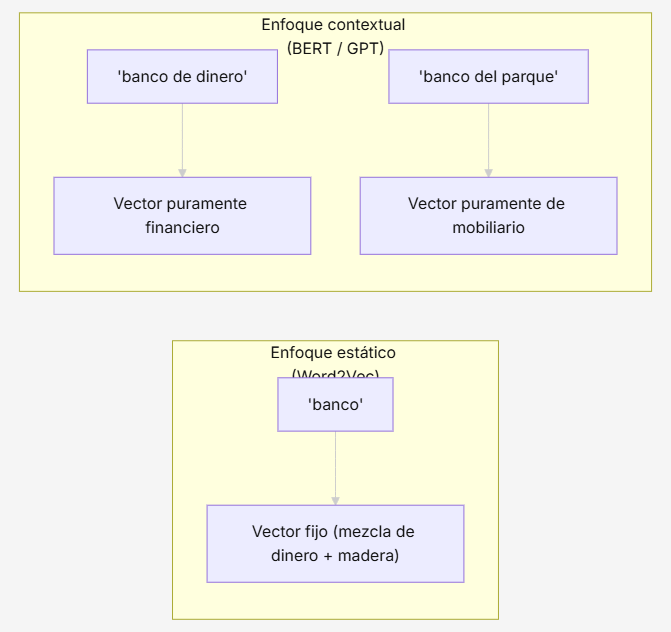
La palabra deja de ser un punto inmóvil y se convierte en una partícula que se desplaza hacia la zona de finanzas o hacia la de carpintería según quién la acompañe.
¿Cómo se fabrica un embedding contextual?
A diferencia de Word2Vec (donde bastaba una consulta en una tabla fija), aquí el embedding es el resultado de un proceso de refinamiento capa a capa:

- Embedding inicial: la palabra entra con un vector genérico de partida, su «yo neutro».
- Positional Encoding: se le añade información de posición (no es lo mismo ir al principio que al final de la frase).
- Self-Attention: cada token «conversa» con todos los demás y decide a cuáles mirar.
- Multi-Head y Feed-Forward: en cada bloque, el vector absorbe matices sintácticos y semánticos.
El vector que sale al final ya no es la palabra aislada: es la palabra impregnada de toda la frase.
Ejemplo intuitivo: el test del pronombre
El caso más claro se ve resolviendo pronombres, el punto donde los modelos estáticos se estrellaban:
Frase A: «The animal didn’t cross the street because it was tired.»
La palabra «it» dirige su atención hacia «animal», ignora «street» y ajusta su vector para reflejar que it = animal (algo vivo, que se cansa).
Frase B: «The street was closed because it was under construction.»
Ahora «it» apunta a «street», y su embedding cambia por completo (algo físico, en obras).
Misma palabra, dos coordenadas radicalmente distintas. El modelo no «entiende» como un humano, pero sus vectores se adaptan con precisión quirúrgica a la lógica de la oración.
¿Por qué fueron un antes y un después?
Los embeddings contextuales no mejoraron una cosa: desbloquearon varias a la vez.
- Desambiguación automática. Una palabra deja de tener un significado fijo; el modelo lo construye según la frase.
- Representaciones profundas. Cada capa del Transformer produce una versión más rica y matizada del embedding, desde la sintaxis hasta la semántica pura.
- Transfer learning masivo. Modelos como BERT demostraron que, una vez entrenados en corpus gigantes, esos embeddings se reutilizan para clasificación, NER, question answering, análisis de sentimiento o búsqueda semántica, sin empezar de cero cada vez.
- La base de los LLM modernos. GPT, Claude, Gemini, Llama… todos dependen de embeddings contextuales para generar texto coherente.
De palabras a frases, código e imágenes
Al resolver el problema del contexto dinámico, la técnica dejó de limitarse a palabras sueltas. Hoy generamos representaciones de unidades mucho más amplias:
| Tipo de embedding | Qué representa | Para qué sirve |
|---|---|---|
| Palabra | Un token en su contexto | Comprensión fina del lenguaje |
| Frase / Documento | Un párrafo entero condensado | Búsqueda semántica, RAG, clustering |
| Código | Funciones y bloques lógicos (CodeBERT, StarCoder) | Búsqueda y autocompletado de código |
| Multimodal | Texto + imagen + audio juntos (CLIP, GPT-4o) | Conectar una foto con su descripción |
El ejemplo multimodal es el más vistoso: una fotografía de un atardecer y la frase «puesta de sol rojiza» acaban compartiendo coordenadas vectoriales muy cercanas, aunque una sea píxeles y la otra letras.
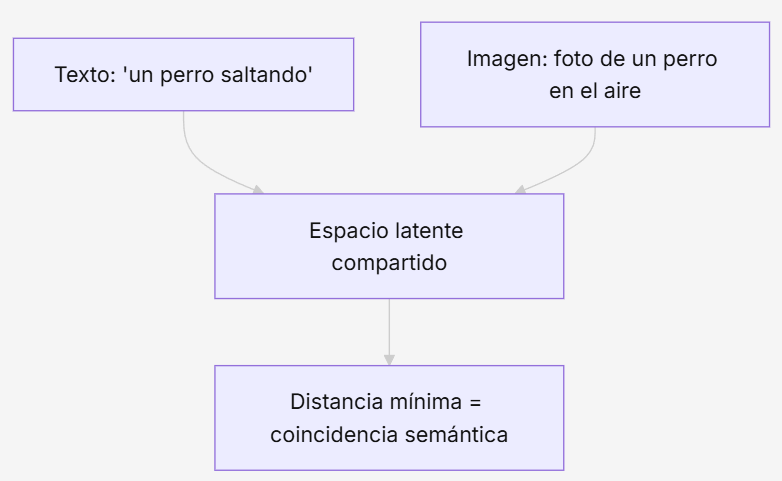
Todos comparten la misma idea de fondo: representar el significado como geometría en un espacio latente.
En resumen
Los embeddings contextuales representan la madurez de la lingüística computacional:
- Reemplazaron los vectores estáticos por significado dinámico que cambia según la frase.
- Son el producto directo de la atención: no existirían sin el self-attention que calcula relaciones globales.
- Habilitan la comprensión profunda en los Transformers, capa a capa.
- Son el motor oculto de la búsqueda semántica, el RAG y el razonamiento de los LLM.
- Unificaron las modalidades: texto, código, audio e imagen hablando el mismo idioma geométrico.
Fue el momento exacto en el que el lenguaje dejó de ser una lista estática de palabras… y se convirtió en un espacio matemático vivo, donde el significado se puede medir, comparar y manipular en tiempo real.