

LLMs: cómo funcionan los modelos de lenguaje modernos por dentro
El mecanismo real detrás de GPT, Claude, Gemini y Llama
Cómo los modelos modernos convierten texto en tokens, predicen el futuro y generan lenguaje coherente.
Hasta ahora hemos recorrido todo el camino evolutivo:
Cada pieza nos acercaba a una pregunta inevitable, la que de verdad quiere resolver cualquiera que use ChatGPT por primera vez:
¿Qué ocurre exactamente dentro del modelo cuando le escribes una frase?
La respuesta es casi paradójica: en su núcleo más íntimo, la idea es sorprendentemente simple; pero la ingeniería necesaria para que funcione resulta colosal.
Un LLM solo hace una cosa: predecir el siguiente token.
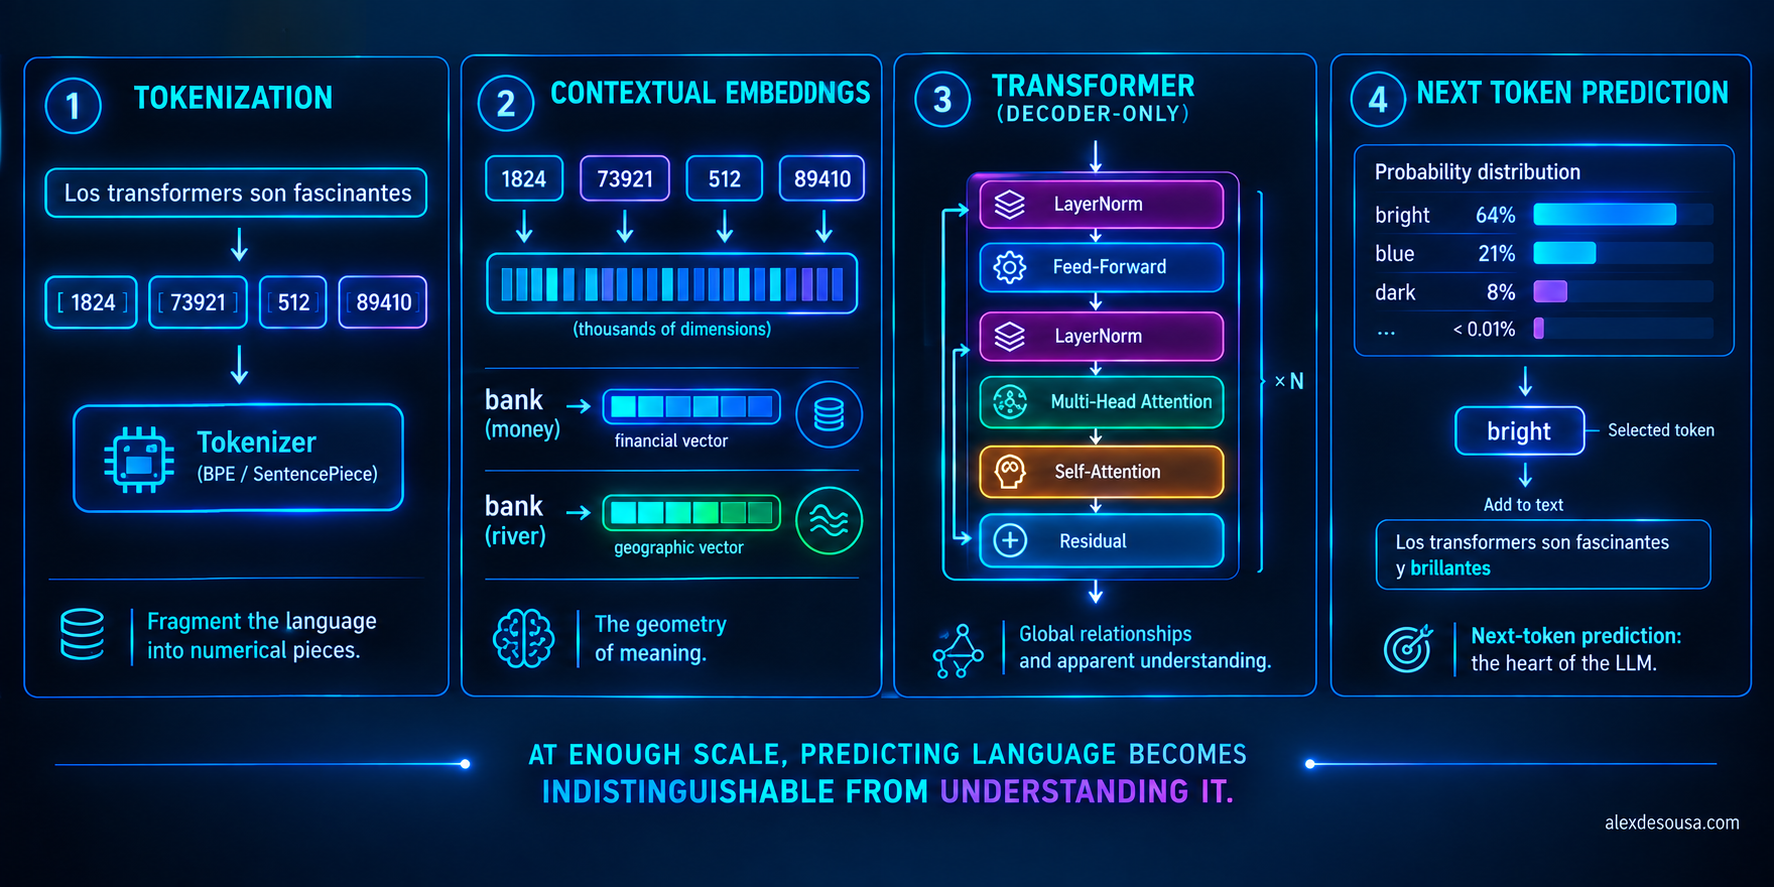
No piensa como un humano ni consulta una base de datos interna. Es un sistema estadístico masivo que calcula probabilidades. Para que esa predicción parezca razonamiento genuino, se apoya en una cadena precisa de engranajes: tokenización, embeddings, atención, miles de capas y billones de parámetros. Vamos a abrirlos uno a uno.
1. ¿Qué es un LLM? (Y qué es realmente un «token»)
Un LLM (Large Language Model) es una red neuronal gigante entrenada para una única tarea: dada una secuencia de texto previa, decidir cuál es la pieza más lógica que debería venir a continuación.
Esa «pieza» no siempre es una palabra entera: es un token.
- Palabras comunes suelen ser un único token:
"gato","sol". - Palabras largas o técnicas se parten en trozos:
"transformers"→["trans", "former", "s"]. - En código o en idiomas con poca presencia online, un token puede ser apenas un par de caracteres sueltos.
La analogía del LEGO. El modelo no habla con palabras; habla con piezas de LEGO lingüístico. Tiene un cajón fijo de piezas (su vocabulario, típicamente entre 32.000 y 128.000) y construye cualquier frase combinándolas. Por eso puede manejar palabras raras, erratas y varios idiomas: siempre encuentra una combinación de piezas que encaja.
Esos miles de millones (o billones) de parámetros son la memoria comprimida donde quedan codificados los patrones del lenguaje, los hechos y las estructuras sintácticas que aprendió.
Como regla práctica: 100 tokens ≈ 75 palabras en español.
2. Del texto a las matemáticas: tokenización y embeddings
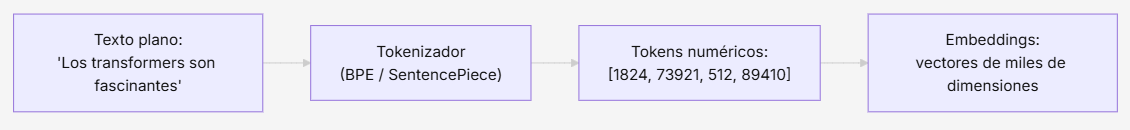
Las computadoras no entienden letras; solo operan con números. La entrada pasa por dos etapas encadenadas:
- Tokenización (BPE o SentencePiece): rompe el texto en identificadores numéricos únicos tomados del vocabulario fijo.
- Embeddings: cada ID se transforma en un vector (una lista de números) en un espacio de miles de dimensiones.
Como vimos en el capítulo anterior, no son vectores estáticos tipo Word2Vec. Son embeddings contextuales: el vector de «banco» se recoloca matemáticamente según sus vecinos (río vs. interés financiero). Los embeddings son, literalmente, la geometría del significado.
3. El Transformer: el motor interno
Prácticamente todos los LLM actuales (GPT-4, Claude, Llama) están construidos sobre la arquitectura Transformer, en su variante Decoder-only: procesan el texto de forma causal, de izquierda a derecha, para continuar la frase.
¿Por qué ganó frente a las RNN? Porque el Transformer puede:
- procesar todos los tokens en paralelo (en lugar de uno a uno),
- conectar cualquier par de palabras en un solo paso,
- y capturar dependencias largas sin perder la señal por el camino.
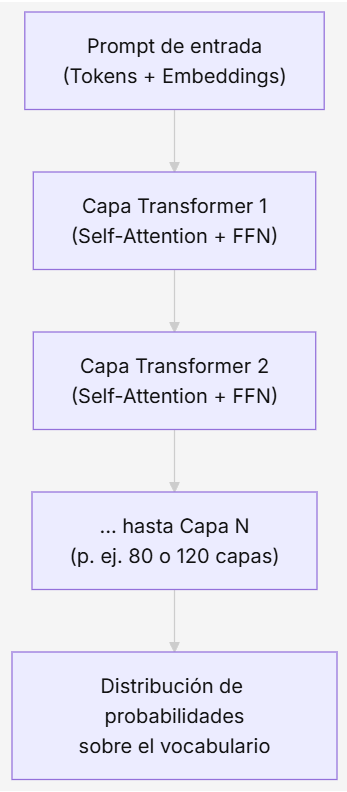
Dentro de cada capa trabajan cinco piezas clave, y cada capa entrega una versión más rica del significado que la anterior:
| Componente | Qué hace | Analogía |
|---|---|---|
| Self-Attention | Decide qué tokens miran a cuáles | Un lector que subraya las palabras conectadas |
| Multi-Head Attention | Repite esa mirada desde decenas de ángulos | Varios expertos leyendo la misma frase |
| Feed-Forward (FFN) | Digiere y almacena hechos y asociaciones | La «biblioteca» interna del modelo |
| LayerNorm | Mantiene los números estables entre capas | El estabilizador que evita que todo explote |
| Residual Connections | Autopistas para que la señal no se degrade | Un atajo que salta de capa en capa |
4. Self-Attention y Multi-Head: quién mira a quién
El corazón del Transformer es la atención: cada token se pregunta «¿a qué otras palabras necesito mirar para entenderme a mí mismo?».
«The animal didn’t cross the street because it was tired.»
La palabra «it» dirige su atención hacia «animal» e ignora «street». Así resuelve pronombres, ambigüedades, concordancias y dependencias largas sin una sola regla programada a mano.
La Multi-Head Attention lleva esto más lejos: en vez de una sola mirada global, lanza decenas de «cabezas» en paralelo, cada una especializada:
- una vigila la sintaxis (sujeto–verbo),
- otra resuelve pronombres,
- otra detecta entidades y nombres propios,
- otra sigue el tiempo verbal o el tono.
Luego se combinan todas en una representación única y enriquecida. Es como tener un comité de lectores expertos analizando la misma frase a la vez.
5. El principio fundamental: predecir el siguiente token
Aquí está la verdad cruda, y conviene decirla sin rodeos:
Un LLM no «piensa», no «entiende» y no «razona» como un humano. Solo predice el siguiente token más probable.
Cuando el prompt cruza todas las capas, el modelo no escupe una respuesta cerrada: genera una tabla de probabilidades sobre todo su vocabulario.
| Token candidato | Probabilidad estimada |
|---|---|
"brillante" |
64.2% |
"azul" |
21.5% |
"oscuro" |
8.1% |
| … (resto de ~100k tokens) | < 0.01% cada uno |
Lo fascinante es la consecuencia: para acertar el siguiente token en millones de contextos distintos (código Python, derecho procesal, medicina, poesía), la red se ve obligada a comprimir internamente patrones lógicos, sintácticos y fácticos muy profundos. La predicción masiva, a suficiente escala, engendra una comprensión aparente.
6. Cómo se construye un LLM: Pretraining vs. Post-training
Un modelo no nace sabiendo responder con amabilidad. Su creación tiene dos fases radicalmente distintas:
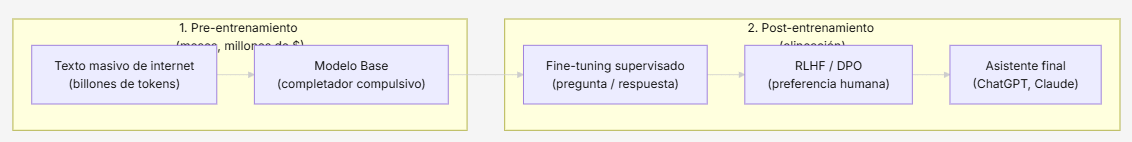
- Pretraining. Se alimenta a la red con billones de tokens de la web, libros y código. El bucle es simple: recibe una secuencia, intenta predecir el siguiente token, compara con el real y ajusta sus parámetros mediante descenso de gradiente. Repetido billones de veces. El resultado es un modelo base: un completador puro. Si le escribes «¿Cuál es la capital de Francia?», quizá no responda «París», sino que siga con «¿Y la de Italia? ¿Y la de España?», porque imita un examen que vio en internet.
- Fine-tuning + RLHF. El modelo base se afina con conversaciones modelo (SFT) y luego con aprendizaje por refuerzo guiado por humanos (RLHF, Reinforcement Learning from Human Feedback). Aquí el completador estadístico aprende su papel de asistente: seguir instrucciones, ser útil, mantener coherencia, evitar respuestas dañinas y admitir cuando no sabe algo.
7. Inferencia y sampling: por qué no siempre dice lo mismo
Cuando usas el modelo (inferencia), el texto se produce de forma autoregresiva: cada token elegido se pega al final y vuelve a entrar para calcular el siguiente.
Importante: el modelo genera token a token, no palabra a palabra. Y no siempre elige el token número uno. Para regular su conducta se usan hiperparámetros de muestreo (sampling):
- Temperatura: cerca de $0$ se vuelve determinista y conservador (ideal para matemáticas o extracción de datos); entre $0.7$ y $1.2$ aplana las diferencias y gana variedad y creatividad.
- Top-k: restringe la elección a los $k$ tokens más probables (por ejemplo, los 40 mejores).
- Top-p (Nucleus Sampling): elige el grupo acumulado de tokens cuya probabilidad sume un umbral (por ejemplo, el 90% superior), adaptándose dinámicamente a la certeza del modelo.
Estos tres mandos controlan el equilibrio entre coherencia, diversidad, creatividad y estilo.
8. Límites fundamentales: qué NO es un LLM
Entender el mecanismo interno explica de inmediato sus fallos típicos. No son bases de datos; son modelos estadísticos, y de ahí vienen sus debilidades:
| Limitación | Causa técnica interna |
|---|---|
| Alucinaciones | Prioriza la verosimilitud estadística del lenguaje sobre la verificación empírica de los hechos. |
| Sensibilidad al prompt | Pequeños cambios al inicio alteran los pesos de atención en capas tempranas y cambian toda la trayectoria probabilística. |
| Falta de memoria real | No «recuerda» de forma continua; solo procesa la ventana de contexto que cabe en el prompt actual. |
| Sesgos heredados | Si un sesgo está en el corpus de internet, el modelo lo codifica en sus matrices de pesos. |
9. El ecosistema actual: más allá del texto puro
Los LLM han dejado de ser simples cajas de texto predictivas para convertirse en orquestadores de software y la interfaz universal entre humanos y máquinas:
- RAG (Retrieval-Augmented Generation): conectar el modelo con buscadores vectoriales para que consulte fuentes verificadas antes de responder.
- Function calling y agentes: el modelo predice llamadas a APIs o fragmentos de código que un entorno externo ejecuta para interactuar con bases de datos y herramientas.
- Multimodalidad nativa: procesar tokens de texto, audio y fragmentos visuales (patches) dentro del mismo espacio vectorial del Transformer.
Sobre esta base funcionan hoy los asistentes inteligentes, los agentes autónomos, el análisis de documentos, la generación de código y la búsqueda semántica.
En resumen
Los Large Language Models operan bajo una arquitectura sistemática:
- Fragmentan el lenguaje en unidades numéricas llamadas tokens.
- Mapean esos tokens en vectores con contexto dinámico (embeddings).
- Ponderan relaciones mediante la atención multicabeza en capas profundas de Transformers.
- Calculan probabilidades para el siguiente token a partir de patrones masivos aprendidos en internet.
- Moldean su conducta mediante alineación supervisada (SFT) y evaluación humana (RLHF).
- Generan texto token a token, de forma autoregresiva.
No son mentes pensantes ni oráculos infalibles: son calculadoras estadísticas de una escala colosal. Su logro histórico es que, a suficiente escala, predecir el lenguaje con precisión matemática se vuelve indistinguible de comprenderlo.