

Ciclo de vida de un modelo de Machine Learning: del experimento a producción
Cómo un modelo pasa de una prueba en un notebook a generar valor en el mundo real
El viaje completo desde los datos crudos hasta la monitorización en producción.
Durante gran parte de esta serie hemos diseccionado modelos: árboles de decisión, redes neuronales, Transformers, LLMs y sistemas multimodales. Hemos abierto sus tripas para entender cómo piensan.
Pero existe una verdad incómoda que todo profesional descubre, casi siempre a golpes:
Un modelo que funciona de maravilla en un notebook no vale absolutamente nada.
Puede alcanzar un 99% de accuracy. Puede generar texto brillante. Puede reconocer tumores mejor que un radiólogo veterano. Y, aun así, fracasar estrepitosamente en cuanto toca el mundo real.
La razón es sencilla y contraintuitiva:
El Machine Learning no termina cuando acaba el entrenamiento. Ahí es, justamente, donde empieza la parte difícil.
Porque un modelo útil no es un algoritmo congelado en un archivo. Es un sistema vivo. Y como todo lo que está vivo, necesita alimentarse, adaptarse y evolucionar… o muere.
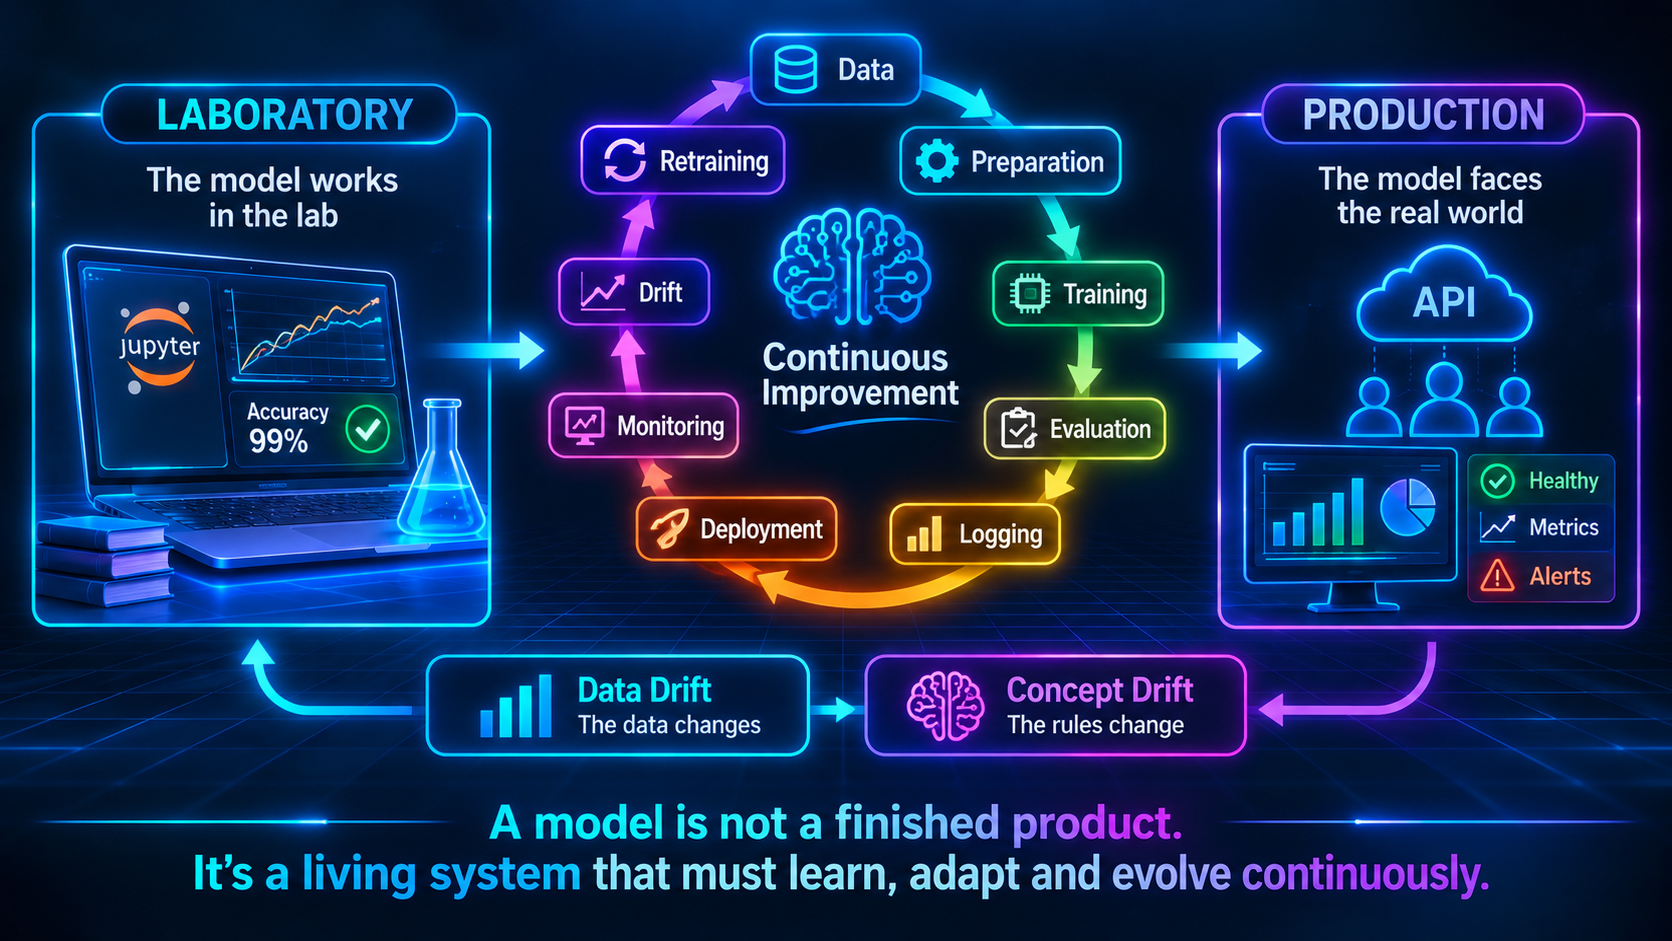
1. El gran malentendido: creer que entrenar es la meta
Cuando damos nuestros primeros pasos en Machine Learning, imaginamos un proceso limpio, lineal y romántico:
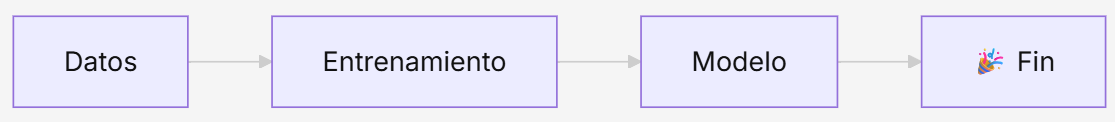
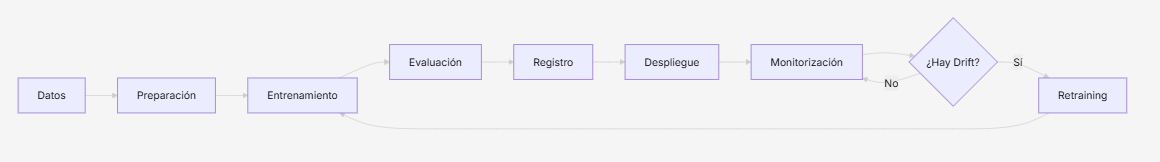
La realidad de un proyecto en producción es mucho menos glamurosa y bastante más circular. Se parece más a esto:
La analogía del restaurante. Entrenar un modelo es como cocinar un plato espectacular una sola vez en la prueba de un concurso. Pero montar un restaurante (producción) es otra historia: hay que comprar ingredientes frescos cada día, mantener la calidad constante ante cientos de comensales, adaptar la carta cuando cambian los gustos y asegurarte de que el plato número 5.000 sepa igual de bien que el primero. El entrenamiento es solo una etapa dentro de un ciclo mucho más largo.
2. Fase 1 — Los datos: el combustible que todo lo determina
Todo empieza aquí. No con los algoritmos, no con PyTorch ni TensorFlow. Con los datos.
La regla de oro es implacable y no tiene excepciones:
La calidad de un modelo jamás podrá superar la calidad de los datos que recibe.
Es el célebre principio Garbage In, Garbage Out (basura entra, basura sale). Puedes tener la arquitectura más sofisticada del planeta, pero si la alimentas con datos sucios, sesgados o incompletos, obtendrás predicciones basura con una confianza alarmante.
En esta fase vive el trabajo menos glamuroso y, a la vez, el más decisivo:
- recopilación de fuentes
- limpieza y tratamiento de valores nulos
- eliminación de duplicados
- ingeniería de variables (feature engineering)
- etiquetado
El dato que sorprende a todos: diversas encuestas del sector (como las de Anaconda o Forbes) estiman que los científicos de datos dedican alrededor del 80% de su tiempo a preparar y limpiar datos, y solo un 20% a lo que la gente imagina como «hacer IA». La parte sexy es la punta del iceberg.
3. Fase 2 — Entrenamiento: aprender del pasado
Esta es la fase que todos conocen y la que acapara los titulares. Aquí el modelo examina los datos históricos y extrae patrones de ellos.
Dependiendo del problema (regresión, clasificación, clustering, deep learning o el ajuste de un LLM), puede durar desde unos segundos en tu portátil hasta semanas en cientos de GPUs costando millones de euros.
Pero, bajo toda esa variedad, late siempre el mismo principio:
El modelo aprende del pasado para intentar predecir el futuro.
Y aquí está la semilla de casi todos los problemas que vendrán después: el modelo asume, de forma implícita, que el futuro se parecerá al pasado. Spoiler: no siempre es así.
4. Fase 3 — Evaluación: ¿aprendió o solo memorizó?
Antes de confiar en un modelo, hay que responder a la pregunta más importante de todas:
¿De verdad ha entendido el problema, o simplemente ha memorizado las respuestas del examen?
Ese fenómeno de «empollar sin comprender» se llama sobreajuste (overfitting): el modelo clava los ejemplos que ya vio, pero se derrumba ante cualquier dato nuevo. Es como el estudiante que memoriza las soluciones del libro pero suspende en cuanto le cambian ligeramente el enunciado.
Para desenmascararlo, lo evaluamos con datos que nunca vio durante el entrenamiento, usando herramientas como:
| Técnica / Métrica | Qué nos dice en lenguaje humano |
|---|---|
| Hold-Out / Cross Validation | Separar un «examen sorpresa» que el modelo no pudo estudiar. |
| Matriz de confusión | Dónde acierta y, sobre todo, en qué tipo de errores cae. |
| Precision | De todo lo que marcó como positivo, ¿cuánto lo era de verdad? |
| Recall | De todos los positivos reales, ¿cuántos logró cazar? |
| F1-Score | El equilibrio justo entre Precision y Recall. |
| ROC-AUC | Su capacidad global para distinguir entre clases. |
Aquí se decide si el modelo tiene permiso para salir del laboratorio.
5. Fase 4 — Registro y versionado: el fin del caos
Y ahora aparece un problema que no sale en los tutoriales. Tras decenas de experimentos, tu carpeta acaba pareciéndose a esto:
modelo_final.pkl
modelo_final_v2.pkl
modelo_final_v3_definitivo.pkl
modelo_final_v3_definitivo_AHORA_SI.pkl
modelo_final_v3_definitivo_el_bueno_de_verdad.pkl
¿Cuál se entrenó con qué datos? ¿Cuál dio mejor F1? ¿Cuál está realmente en producción? Nadie lo sabe. El caos absoluto.
Por eso los sistemas modernos de MLOps introducen disciplina industrial:
- Versionado: cada modelo tiene una identidad única y rastreable.
- Trazabilidad: sabemos exactamente qué datos y qué parámetros lo generaron.
- Registro de métricas y artefactos: todo queda guardado y comparable.
Herramientas como MLflow, DVC o Weights & Biases nacieron precisamente para convertir ese caos de archivos sueltos en un historial ordenado, igual que Git hizo con el código.
6. Fase 5 — Despliegue: el salto al vacío real
Aquí el modelo abandona el cómodo laboratorio y se enfrenta al mundo salvaje: datos reales, clientes reales, peticiones inesperadas y errores reales que cuestan dinero.
No todos los modelos se sirven de la misma forma. Hay tres grandes estrategias según la urgencia:
| Modo de despliegue | Cómo funciona | Ejemplo típico |
|---|---|---|
| Batch (por lotes) | Procesa miles de registros de golpe, en horarios fijos (ej. cada noche). | Recomendaciones de productos que ves al día siguiente. |
| Tiempo real (API) | Petición → predicción inmediata → respuesta en milisegundos. | Aprobar o denegar una compra con tarjeta al instante. |
| Streaming | Flujo continuo de datos que genera predicciones sin parar. | Detección de anomalías en sensores de una fábrica 24/7. |
Es el momento mágico: por fin, el modelo empieza a generar valor de verdad.
7. Fase 6 — Monitorización: todos los modelos se degradan
Y aquí llega la lección más dura y humilde de la producción:
Todos los modelos se degradan con el tiempo. No es una posibilidad: es una certeza matemática.
El mundo cambia. Los clientes cambian de hábitos, llegan competidores nuevos, estalla una pandemia, cambia una ley. Y tu modelo, que aprendió un retrato fiel del mundo de ayer, se vuelve cada día un poco más obsoleto.
Por eso no basta con desplegar y olvidarse: hay que vigilar constantemente dos tipos de señales.
- Señales técnicas: latencia (¿responde rápido?), tasa de errores, consumo de recursos.
- Señales de negocio y calidad: precisión real, y sobre todo, si la distribución de los datos de entrada sigue pareciéndose a la del entrenamiento.
8. Drift: cuando el mundo deja atrás a tu modelo
Esa degradación tiene un nombre propio y es el gran fantasma del MLOps: el drift (deriva). Se presenta en dos sabores que conviene no confundir.
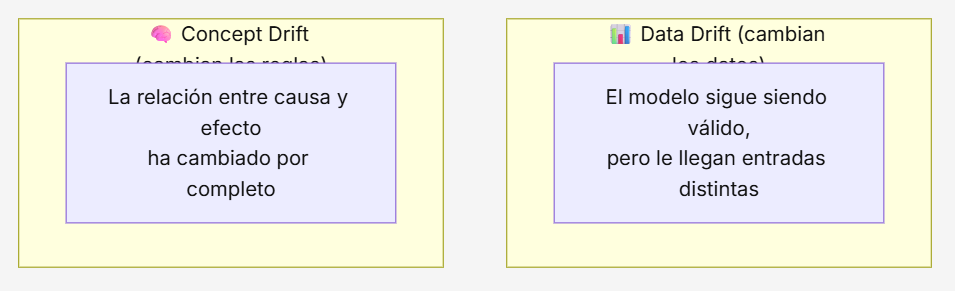
Data Drift: cambian los datos de entrada
Las características de lo que entra se desvían de lo que el modelo conoció.
Ejemplo: un detector de fraude entrenado con transacciones de 2023 empieza a recibir en 2026 un aluvión de pagos por móvil y criptomonedas que apenas existían antes. El patrón de «normalidad» ha cambiado bajo sus pies.
Concept Drift: cambian las reglas del juego
Lo más traicionero: la relación misma entre las variables y el resultado se rompe.
Ejemplo clásico: los modelos de demanda de supermercados de principios de 2020. De la noche a la mañana, «papel higiénico» y «harina» pasaron de productos predecibles a artículos de pánico. Las reglas aprendidas dejaron de ser ciertas, aunque los datos «parecieran» normales.
En ambos casos, el modelo sigue funcionando y devolviendo respuestas con total aplomo… pero cada vez se equivoca más. Es un deterioro silencioso y peligroso.
9. Retraining: volver a enseñar
Cuando la monitorización detecta drift, solo hay dos caminos:
- Aceptar el deterioro (y asumir las pérdidas).
- Reentrenar el modelo con información fresca.
La respuesta correcta casi siempre es obvia. El retraining inyecta la realidad actual en el sistema:
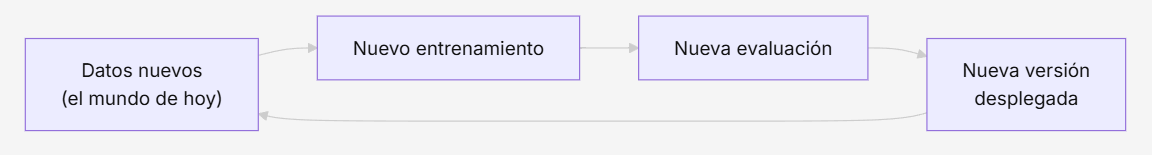
Y así, el ciclo vuelve a empezar. La gran pregunta estratégica no es si reentrenar, sino cuándo: ¿cada noche? ¿cada semana? ¿solo cuando una alarma de drift salta? Ese equilibrio entre coste y frescura es uno de los grandes retos del MLOps.
10. El ciclo que nunca termina
Aquí reside la diferencia abismal entre un ejercicio académico y un sistema real en producción.
| Proyecto académico | Sistema en producción | |
|---|---|---|
| Objetivo | Publicar un buen resultado | Generar valor sostenido |
| Final | Termina al entregar/publicar | No termina nunca |
| Datos | Fijos, limpios, estáticos | Vivos, sucios, cambiantes |
| Éxito | Buena métrica en el paper | Fiabilidad durante años |
Un proyecto académico acaba cuando se publica el resultado. Un sistema de Machine Learning real, en cambio, entra en un bucle perpetuo: entrenar → desplegar → monitorizar → detectar drift → reentrenar → volver a desplegar. Y repetir, una y otra vez, durante años.
En resumen
El ciclo de vida completo de un modelo moderno abarca mucho más que el entrenamiento:
- recopilación y preparación de datos (el 80% silencioso del trabajo),
- entrenamiento a partir del pasado,
- evaluación honesta contra datos nunca vistos,
- registro y versionado para acabar con el caos de archivos,
- despliegue en batch, tiempo real o streaming,
- monitorización continua de la salud del sistema,
- detección de drift antes de que haga daño,
- y retraining para mantenerlo vivo.
La lección más importante de todas cabe en una sola frase:
Un modelo no es un producto terminado; es un sistema vivo.
El momento en que pasa a producción no es el final del proyecto… es el principio de su verdadera vida.