

Sampling y decoding: cómo un LLM decide qué decir
Por qué dos modelos que «saben» exactamente lo mismo pueden contestarte cosas totalmente distintas
Ya hemos visto cómo un modelo de lenguaje lee (tokenización), cómo guarda el significado (embeddings), cómo conecta ideas (atención) y cómo adivina la siguiente palabra.
Pero queda una pregunta que parece simple y no lo es:
Si un modelo solo calcula probabilidades… ¿quién decide la palabra que finalmente escribe?
La respuesta es más curiosa de lo que parece. Porque el conocimiento de un modelo no cambia de una respuesta a otra: lo que cambia es la forma de elegir. Y esa forma de elegir es, en el fondo, lo que le da «carácter».
Una frase para quedarse con ella:
El conocimiento vive en los pesos del modelo. La personalidad nace en cómo escoge las palabras.
1. El instante de la decisión
Imagina que escribimos:
«The sky is…» («El cielo está…»)
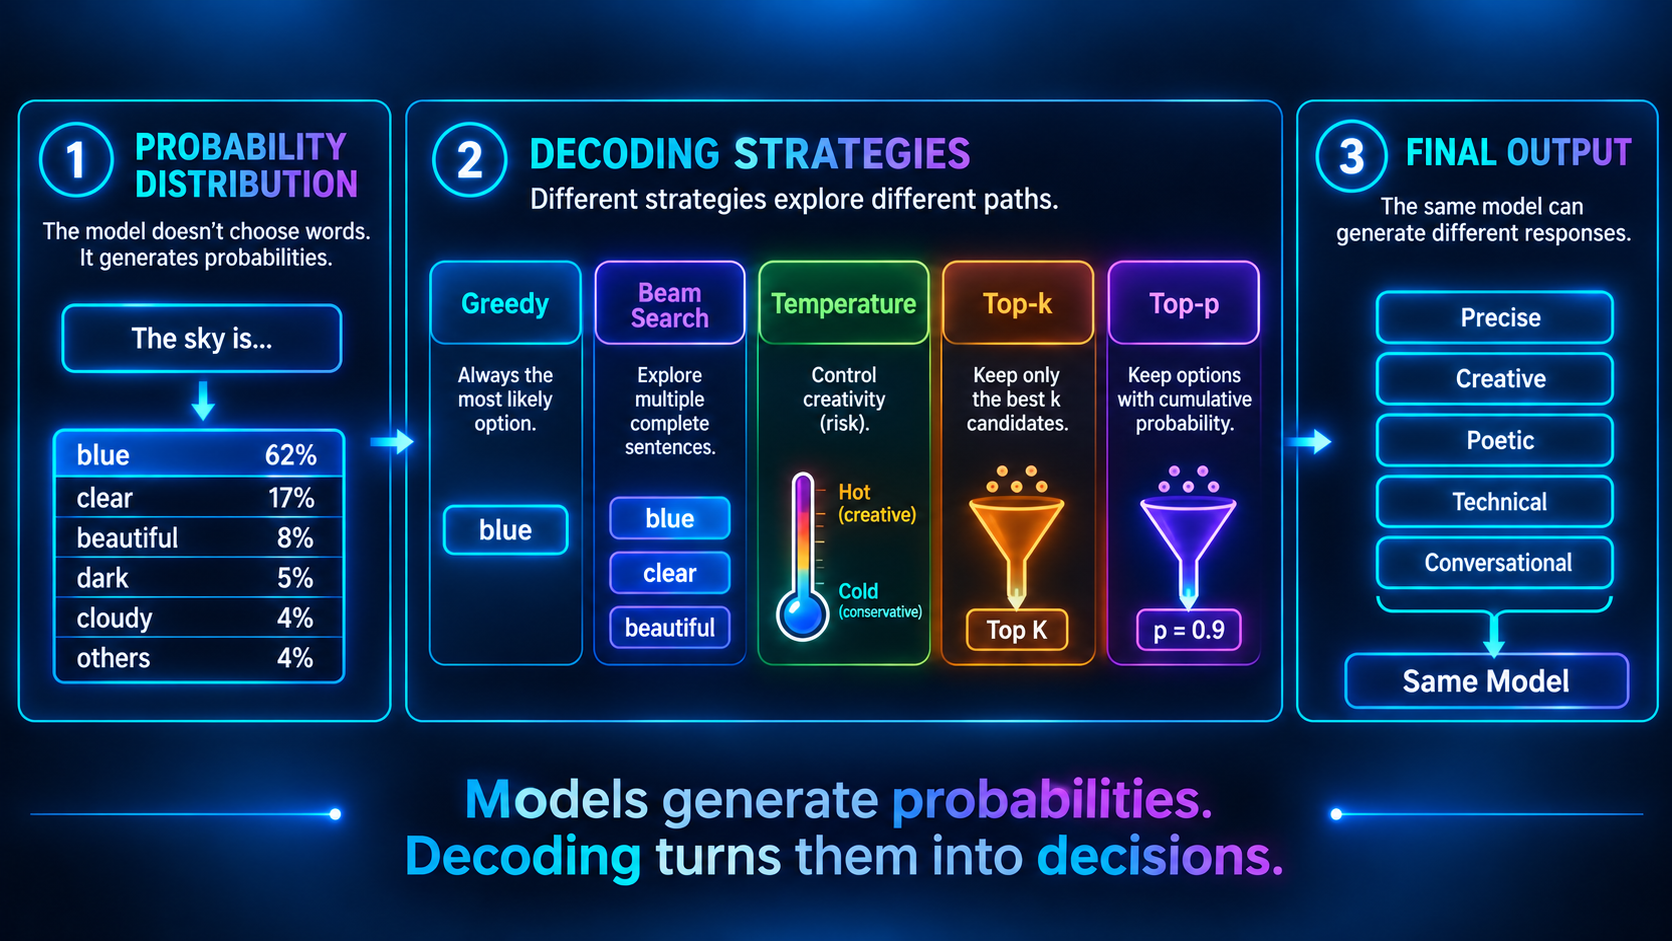
El modelo no responde una palabra. Responde una lista de candidatos con su probabilidad, algo así:
| Palabra | Probabilidad |
|---|---|
| blue (azul) | 62 % |
| clear (despejado) | 17 % |
| beautiful (precioso) | 8 % |
| dark (oscuro) | 5 % |
| cloudy (nublado) | 4 % |
| resto | 4 % |
Esto es lo que se llama distribución de probabilidad. Fíjate en el detalle clave: el modelo no sabe la respuesta correcta. Solo dice:
«Por todo lo que leí durante mi entrenamiento, esto es lo más probable que venga a continuación.»
A partir de aquí entra en juego el verdadero protagonista de este post: el algoritmo que convierte esa lista en una palabra concreta.
2. Greedy: el alumno que nunca se arriesga
La estrategia más sencilla del mundo:
Elige siempre la palabra más probable. Punto.
En nuestro ejemplo: The sky is → blue. Y vuelta a empezar con la siguiente.
Es rápido, predecible y fácil. Si le das la misma frase diez veces, te da la misma respuesta diez veces.
¿El problema? Es tremendamente cortoplacista. Solo mira el paso siguiente, nunca si esa elección va a arruinar la frase más adelante. Es como jugar al ajedrez pensando solo en la jugada que tienes delante, sin mirar lo que viene después. A veces la mejor palabra ahora lleva a un callejón sin salida después.
3. Beam Search: no te cases con la primera idea
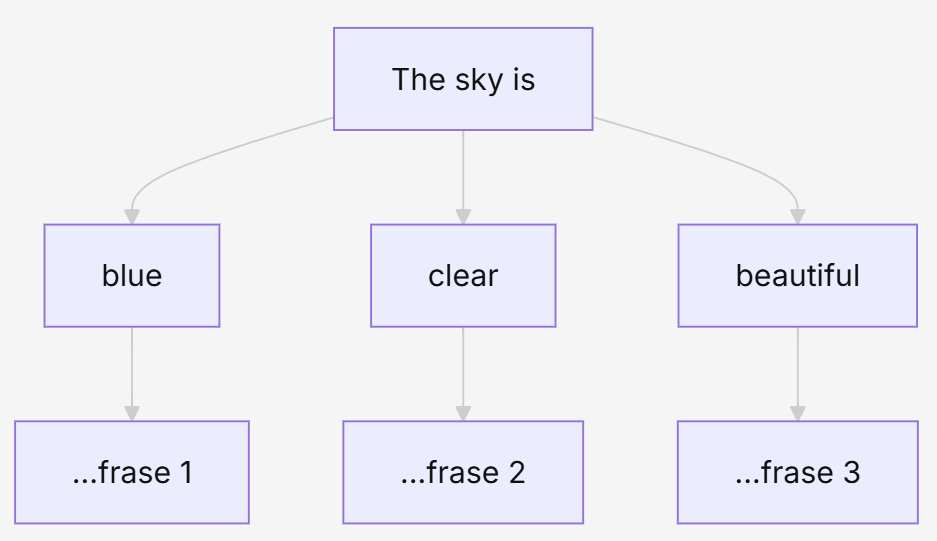
Beam Search es más listo: en vez de comprometerse con una sola opción, mantiene varias frases candidatas abiertas a la vez y va viendo cuál funciona mejor en conjunto.
Con un «ancho» de 3, por ejemplo, sigue explorando tres caminos en paralelo:
- The sky is blue…
- The sky is clear…
- The sky is beautiful…
Al final se queda con la frase completa que mejor encaja, no con la mejor palabra suelta.
Funciona de maravilla cuando hay una respuesta «correcta» que buscar: traducir un texto, resumir un documento. Pero tiene un pero: tiende a ser soso y repetitivo, porque siempre va a lo seguro. Por eso los chatbots que quieren sonar naturales casi nunca lo usan.
4. Temperature: el termostato de la creatividad
Aquí empieza lo divertido. La temperatura no cambia lo que el modelo sabe; cambia cuánto se arriesga al elegir.
La idea en una frase: ¿quieres un modelo prudente o uno atrevido?
Temperatura baja (ej. 0,1) → exagera las diferencias. El favorito se vuelve casi imparable:
| Palabra | Antes | Con T baja |
|---|---|---|
| blue | 62 % | 94 % |
| clear | 17 % | 4 % |
| beautiful | 8 % | 1 % |
Resultado: respuestas seguras y previsibles.
Temperatura alta (ej. 1,5) → aplana las diferencias. Los outsiders tienen más oportunidad:
| Palabra | Con T alta |
|---|---|
| blue | 40 % |
| clear | 22 % |
| beautiful | 18 % |
| dark | 12 % |
Resultado: respuestas más variadas y sorprendentes (a veces, también más disparatadas).
La analogía: la temperatura es el mando del riesgo. Bájalo y tienes un ingeniero meticuloso; súbelo y tienes un escritor con imaginación desbordada.
5. Top-k: quédate solo con los mejores candidatos
Otra idea sencilla y eficaz:
Descarta todo menos las k mejores opciones, y elige solo entre esas.
Con Top-k = 3 nos quedamos con blue, clear y beautiful, y tiramos a la basura las miles de opciones absurdas que tenían una probabilidad minúscula.
Así el modelo sigue teniendo libertad para sorprender, pero sin soltar de repente una palabra sin sentido. Creatividad, pero con red de seguridad.
6. Top-p (nucleus sampling): el estándar de hoy
Top-k tiene una pega: fijar un número fijo de candidatos no siempre encaja. A veces 3 opciones se quedan cortas; otras veces sobran la mitad.
Top-p lo resuelve de forma más inteligente:
No fija un número de candidatos, fija un porcentaje de confianza acumulada.
Con Top-p = 0,9, el modelo va sumando candidatos (del más probable al menos) hasta llegar al 90 % de probabilidad, y descarta el resto:
| Palabra | Probabilidad | ¿Entra? |
|---|---|---|
| blue | 62 % | ✅ |
| clear | 17 % | ✅ |
| beautiful | 8 % | ✅ |
| dark | 5 % | ✅ (suma 92 %) |
| cloudy | 4 % | ❌ |
Lo bueno: el grupo de candidatos se ajusta solo según el contexto. Si el modelo está muy seguro, considera pocas opciones; si duda, abre el abanico. Por eso Top-p es hoy el método dominante en los modelos modernos.
7. Repetition penalty: cortar los bucles
Un clásico incómodo:
The cat was sleeping.
The cat was sleeping.
The cat was sleeping.
A los modelos les encanta repetir patrones. La penalización por repetición lo evita con una regla simple: cada vez que una palabra ya ha salido, pierde puntos y se vuelve menos tentadora. Así el modelo se ve empujado a buscar nuevos caminos en lugar de dar vueltas en círculos.
8. La idea que lo cambia todo: los modelos no escriben, apuestan
Este es el «truco de magia» detrás de todo. Un LLM nunca decide:
«Voy a decir esto.»
Lo que hace de verdad es:
«Estas son las probabilidades de todas las palabras que podrían venir ahora.»
Y es el algoritmo de decodificación (greedy, temperature, top-p…) quien convierte esa apuesta en una frase. El modelo pone las probabilidades; la estrategia pone la decisión.
9. Por qué el mismo GPT puede parecer personas distintas
Porque no hace falta cambiar lo que sabe: basta con girar un par de mandos.
| Ajuste | Cómo suena |
|---|---|
| Temperature 0 | Preciso, pero repetitivo |
| Temperature 0,7 | Equilibrado |
| Temperature 1,2 | Creativo |
| Top-p bajo | Prudente |
| Top-p alto | Explorador |
El mismo modelo, sin tocar un solo peso, puede sonar como un profesor, un programador, un escritor o un poeta. Solo cambia la forma de elegir las palabras.
En resumen
Los LLM no te dan una respuesta directamente. Primero construyen una distribución de probabilidades para la siguiente palabra. Y luego una estrategia decide qué camino tomar:
- Greedy → siempre la opción más probable
- Beam Search → explora varias frases a la vez
- Temperature → sube o baja el nivel de riesgo
- Top-k → se queda con los mejores candidatos
- Top-p → ajusta los candidatos según el contexto
- Repetition penalty → evita los bucles
Fue justo aquí donde la IA dejó de limitarse a predecir palabras… y empezó a desarrollar algo que, desde fuera, se parece muchísimo a tener estilo propio.