

Word2Vec (CBOW + Skip-Gram)
El modelo que enseñó a las máquinas el significado de las palabras
Cómo convertir lenguaje en vectores que capturan relaciones, contexto y semántica.
En el capítulo anterior vimos cómo los Autoencoders aprenden a comprimir y reconstruir datos, descubriendo su esencia. Hoy damos un paso más: convertir palabras en vectores que capturan significado.
Antes de Word2Vec, las palabras eran números arbitrarios o vectores one-hot: representaciones enormes, dispersas y sin ningún tipo de semántica.
Para una máquina, «gato» y «perro» eran tan distintos como «gato» y «astronomía». No había forma de saber que dos palabras estaban relacionadas.
Word2Vec cambió eso para siempre.
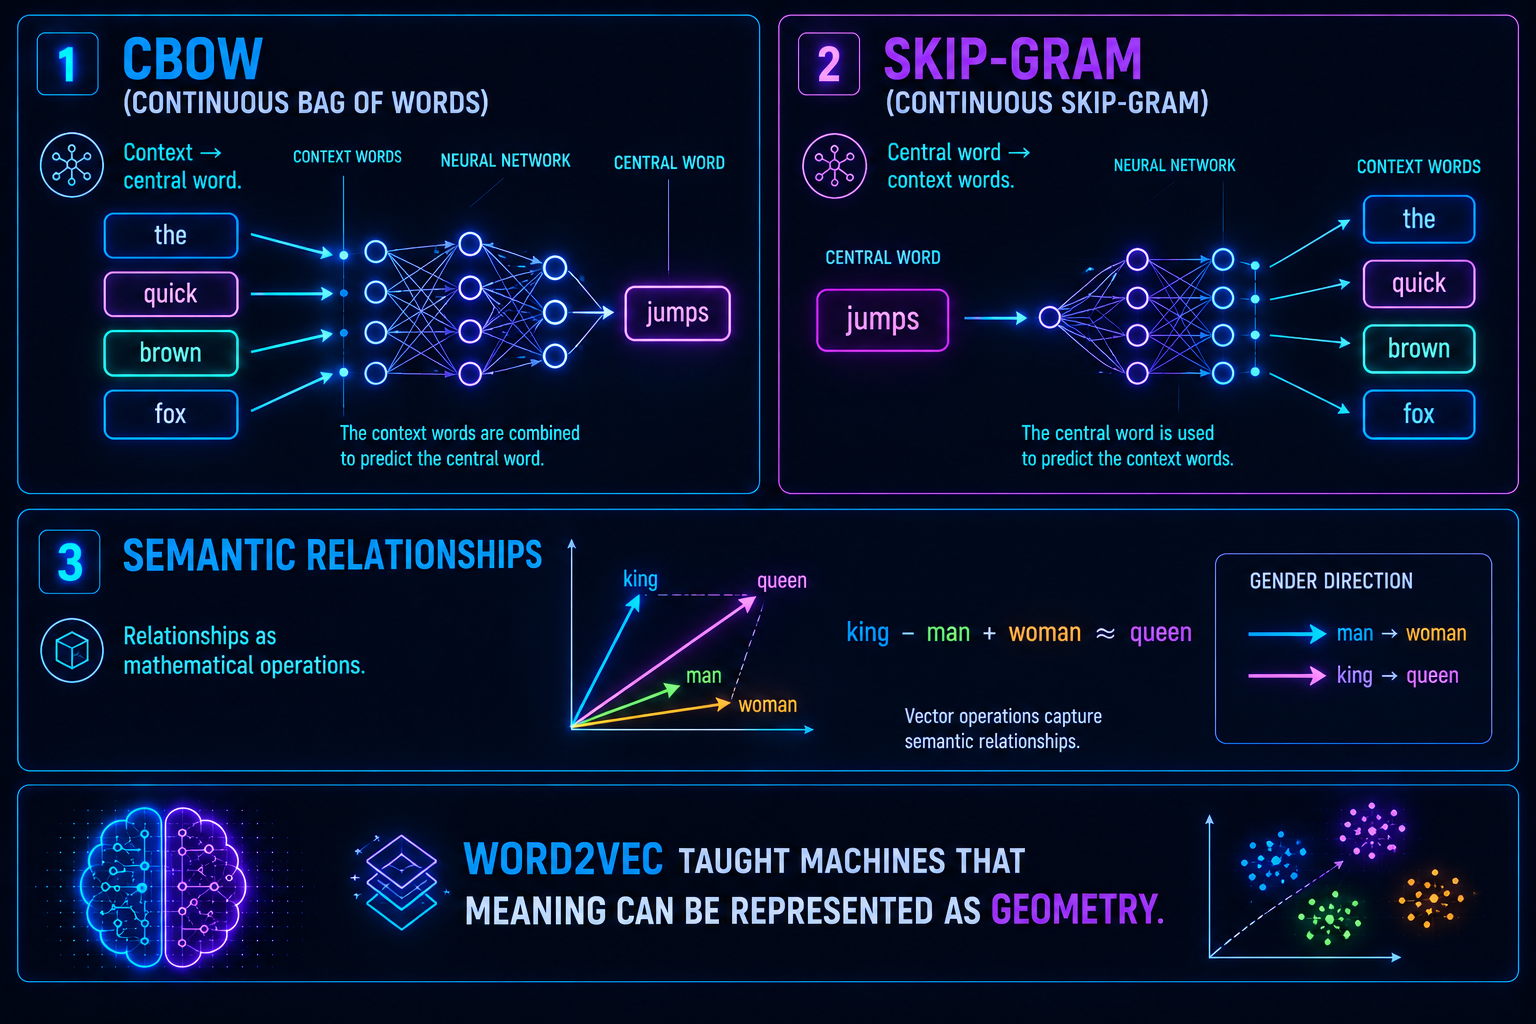
La idea central: palabras con significado geométrico
Word2Vec convierte cada palabra en un vector denso, pequeño y lleno de información. Y lo hace con una idea simple pero poderosa:
Las palabras que aparecen en contextos similares tienen significados similares.
Si «rey», «reina», «castillo», «trono» y «corona» aparecen juntos en muchos textos, sus vectores acabarán cerca en el espacio. Si «perro», «gato», «mascota», «comida» y «veterinario» aparecen juntos, también.
Word2Vec aprende estas relaciones sin que nadie se las diga. Solo leyendo texto.
Una forma de imaginarlo. Piensa en un mapa gigante donde cada palabra es un punto. Al principio están colocadas al azar. A medida que Word2Vec lee millones de frases, va moviendo cada punto: acerca las palabras que suelen aparecer en los mismos contextos y aleja las que no tienen nada que ver. Al final, «gato» y «perro» terminan siendo vecinos, mientras que «astronomía» queda en otro barrio del mapa. Nadie dibujó ese mapa a mano: emergió solo del texto.
¿Qué hace realmente Word2Vec?
Word2Vec no intenta clasificar ni predecir etiquetas. Su objetivo es más sutil:
Aprender representaciones que capturen el contexto de cada palabra.
Para lograrlo, entrena una red neuronal diminuta con una tarea muy simple, que puede plantear de dos formas opuestas:
- CBOW → predecir la palabra central a partir del contexto.
- Skip-Gram → predecir el contexto a partir de la palabra central.
Y aquí está el truco genial: la red nunca es el objetivo. Lo que de verdad nos interesa son los pesos que aprende por el camino. Esos pesos son los embeddings.
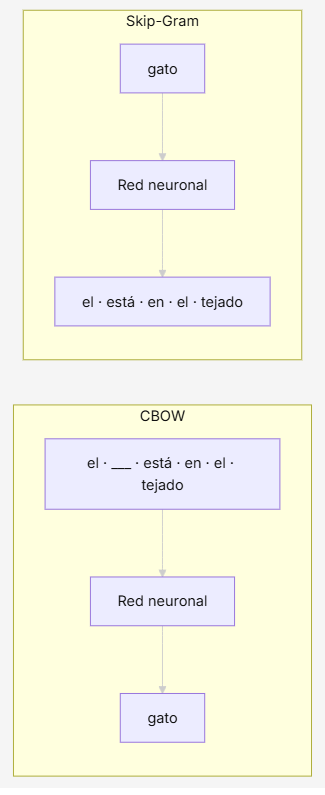
CBOW: aprender a partir del contexto
CBOW (Continuous Bag of Words) funciona así:
«Dime las palabras de alrededor, y yo te digo cuál es la palabra central.»
Ejemplo:
- Contexto: «el ___ está en el tejado»
- Palabra central: «gato»
La red recibe las palabras del contexto y aprende a predecir la palabra que falta. Con miles de ejemplos, descubre qué palabras suelen aparecer juntas, y eso crea vectores que capturan semántica.
✔ Ventajas: es rápido, funciona bien con datasets pequeños y es estable.
Skip-Gram: aprender a partir de la palabra central
Skip-Gram hace exactamente lo contrario:
«Dime la palabra central, y yo te digo qué palabras suelen rodearla.»
Ejemplo:
- Palabra central: «gato»
- Contexto: «el», «está», «en», «el», «tejado»
La red aprende qué palabras suelen aparecer alrededor de «gato».
✔ Ventajas: es mejor para vocabularios grandes, captura relaciones más complejas y produce embeddings más ricos.
¿Cómo se entrena Word2Vec?
Word2Vec usa una red neuronal muy simple:
- Entrada: un vector one-hot.
- Capa oculta: el embedding.
- Salida: la probabilidad de las palabras del contexto.
Pero entrenar esto directamente sería lento: cada predicción tendría que compararse con todo el vocabulario (a veces cientos de miles de palabras). Por eso Word2Vec usa dos trucos inteligentes:
- Negative Sampling. En lugar de predecir todas las palabras del vocabulario, solo actualiza la palabra correcta y unas pocas «negativas» elegidas al azar. Esto acelera el entrenamiento de forma brutal.
- Hierarchical Softmax. Organiza el vocabulario en un árbol para reducir drásticamente el número de cálculos.
Gracias a estos trucos, Word2Vec puede entrenar sobre millones de palabras sin problemas.
La magia: relaciones algebraicas entre palabras
Word2Vec no solo agrupa palabras similares. Hace algo mucho más sorprendente: captura relaciones semánticas como operaciones matemáticas.
El ejemplo clásico:
Lee esa fórmula como una frase: «coge el concepto de rey, quítale lo que tiene de hombre, súmale lo que tiene de mujer… y acabas en reina«. La máquina no sabe qué es la realeza ni el género; simplemente ha colocado los vectores de tal forma que esa resta y esa suma apuntan al lugar correcto del mapa.
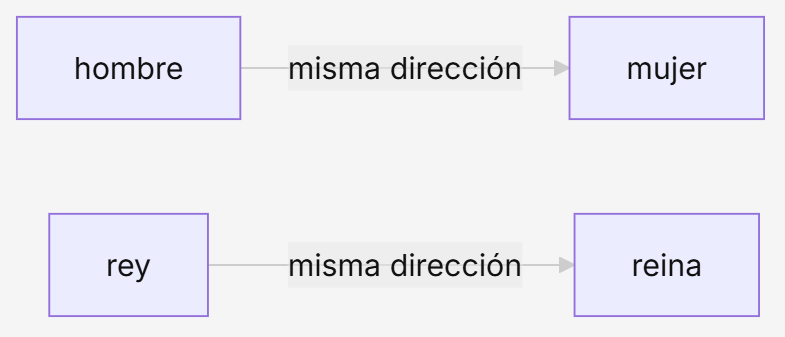
El «salto» de hombre a mujer es casi el mismo vector que el salto de rey a reina. Esa dirección, aprendida sola, es lo que codifica el concepto de género.
Esto ocurre porque los vectores no solo representan palabras, sino conceptos: género, rol, jerarquía, contexto, semántica. Fue la primera vez que una máquina pudo «razonar» sobre palabras usando pura geometría.
¿Por qué Word2Vec fue tan revolucionario?
Porque resolvió tres problemas de golpe:
- Representaciones densas. Pasamos de vectores gigantes y vacíos a vectores pequeños y llenos de significado.
- Semántica emergente. Las relaciones entre palabras aparecían solas, sin supervisión.
- Base para todo lo que vino después. Word2Vec abrió la puerta a GloVe, FastText, los embeddings contextuales, los Transformers, los modelos generativos y los LLMs modernos.
Fue el primer paso hacia el lenguaje vectorial que usan todas las redes actuales.
CBOW vs Skip-Gram: ¿cuál es mejor?
Depende del caso:
| Método | Mejor cuando… | Ventajas |
|---|---|---|
| CBOW | el dataset es pequeño | rápido y estable |
| Skip-Gram | el vocabulario es grande | relaciones más ricas |
En la práctica, Skip-Gram suele producir embeddings más potentes.
El puente hacia GloVe y los embeddings modernos
Word2Vec fue el primer modelo que demostró que el significado puede representarse como geometría.
A partir de ahí, cada modelo añadió una pieza:
- GloVe tomó esa idea y la llevó más lejos usando estadísticas globales del texto.
- FastText añadió las subpalabras, para entender también palabras nuevas o mal escritas.
- Transformers añadieron contexto dinámico.
- Los LLM actuales generan embeddings que cambian según la frase en la que aparece cada palabra.
Pero todo empezó aquí.
En resumen
Word2Vec es el modelo que enseñó a las máquinas el significado de las palabras. Aprende del contexto, genera vectores densos y semánticos, captura relaciones algebraicas, funciona sin supervisión y es la base de todos los embeddings modernos.
Es el puente entre el lenguaje simbólico y el lenguaje vectorial: el primer paso hacia entender el texto como un espacio geométrico lleno de significado.