

GloVe + Sesgos en Embeddings
Cuando el significado emerge de las estadísticas… y también los sesgos del mundo real
Cómo GloVe aprende relaciones globales del lenguaje y por qué los embeddings pueden heredar prejuicios humanos.
En los capítulos anteriores vimos cómo los Autoencoders aprenden a comprimir la esencia de los datos y cómo Word2Vec convierte palabras en vectores que capturan contexto y semántica.
Hoy toca un modelo que llevó esa idea un paso más lejos: GloVe. Y también un tema crucial: los sesgos que aparecen dentro de los embeddings.
Porque si las máquinas aprenden del mundo… también aprenden sus prejuicios.

GloVe: Global Vectors for Word Representation
Word2Vec aprende significado mirando contextos locales: ventanas de unas pocas palabras alrededor de cada término. GloVe hace algo distinto: mira las estadísticas globales de todo el texto de una vez.
La idea central es elegante:
Si dos palabras aparecen juntas con mucha frecuencia, esa relación debe estar codificada en sus vectores.
Pero GloVe no se queda ahí. No solo mira si aparecen juntas, sino cuánto más aparecen juntas comparado con otras combinaciones. Es un modelo que aprende del balance estadístico del lenguaje.
Una forma de imaginarlo. Word2Vec es como alguien que aprende leyendo frase por frase, con una linterna que solo ilumina las palabras vecinas. GloVe, en cambio, es como alguien que primero cuenta todo el libro entero, arma una gran tabla de «quién aparece con quién», y solo después deduce los significados a partir de esos totales.
La intuición: significado como proporciones
Imagina que analizas millones de frases y observas estos cuatro hechos:
- «ice» (hielo) aparece cerca de «cold» (frío) muy a menudo
- «steam» (vapor) aparece cerca de «hot» (caliente) muy a menudo
- «ice» aparece cerca de «hot» muy poco
- «steam» aparece cerca de «cold» muy poco
GloVe observa estas proporciones y concluye, sin ninguna regla escrita a mano:
«ice está más relacionado con cold que con hot»
«steam está más relacionado con hot que con cold»
El truco fino está en las proporciones, no en los conteos sueltos. Fíjate en lo que pasa al comparar las dos palabras frente a una tercera (los números son ilustrativos):
| Palabra de sondeo | Aparece con «ice» | Aparece con «steam» | Proporción ice/steam |
|---|---|---|---|
| solid (sólido) | alta | baja | ≫ 1 → propia del hielo |
| gas | baja | alta | ≪ 1 → propia del vapor |
| water (agua) | alta | alta | ≈ 1 → común a ambos |
| fashion (moda) | baja | baja | ≈ 1 → irrelevante para ambos |
La proporción distingue lo que de verdad separa dos palabras (solid vs gas) de lo que comparten o de lo que no viene al caso. Esa señal es la que GloVe intenta grabar en la geometría de los vectores.
Es como si el modelo dijera:
«Si dos palabras co-ocurren mucho más de lo esperado, deben estar semánticamente conectadas.»
¿Cómo funciona GloVe?
GloVe empieza construyendo una matriz de co-ocurrencias globales de todo el corpus:
- filas → palabras
- columnas → palabras
- valores → cuántas veces aparecen juntas
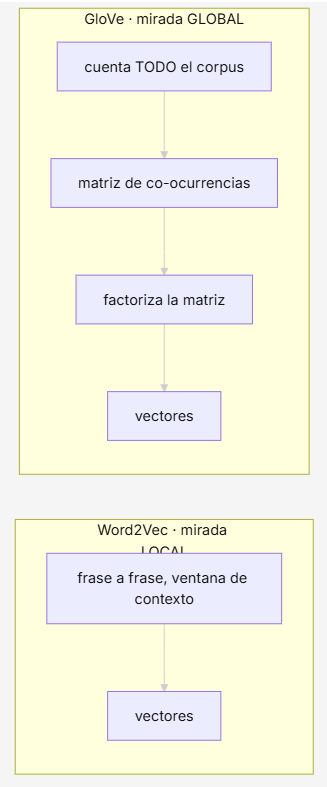
Después, GloVe intenta factorizar esa matriz para obtener vectores densos que reproduzcan esas relaciones. Su función objetivo se basa en una idea sencilla:
La diferencia entre dos vectores debe reflejar la proporción de co-ocurrencias entre sus palabras.
Dicho de otra forma, quiere que el producto de dos vectores se parezca al (logaritmo del) número de veces que esas palabras aparecen juntas:
donde $X_{ij}$ es cuántas veces la palabra i aparece junto a la j. Esto permite que GloVe aprenda analogías, similitudes, direcciones semánticas y conceptos abstractos, todo sin depender de las ventanas locales de Word2Vec.
¿Por qué GloVe fue tan importante?
Porque combinó lo mejor de dos mundos:
- Estadísticas globales del corpus. Captura relaciones que Word2Vec no ve porque quedan fuera de la ventana local.
- Vectores densos y algebraicos. Mantiene las propiedades geométricas que hicieron famoso a Word2Vec (esa «aritmética de palabras» del capítulo anterior).
- Analogías más estables. Relaciones del tipo «king − man + woman ≈ queen» suelen salir más consistentes.
- Base para lo que vino después. GloVe influyó en FastText, en los embeddings contextuales, en los Transformers y en los modelos generativos.
Word2Vec vs GloVe: ¿qué diferencia hay?
| Modelo | Aprende de… | Ventajas |
|---|---|---|
| Word2Vec | contextos locales | rápido, eficiente, muy práctico |
| GloVe | estadísticas globales | analogías más estables, relaciones más amplias |
En la práctica, ambos producen embeddings excelentes. La diferencia es de enfoque: Word2Vec aprende «sobre la marcha» leyendo ventanas, y GloVe aprende de la foto completa del corpus. GloVe suele capturar mejor las relaciones globales del lenguaje.
Sesgos en embeddings: el lado oscuro del significado
Hasta aquí todo parece mágico: vectores que capturan semántica, relaciones, analogías… Pero hay un problema.
Si el texto del mundo tiene sesgos, los embeddings también los tendrán.
Y el texto del mundo sí tiene sesgos. Esta es la otra cara de la moneda: el mismo mecanismo que hace que los embeddings sean tan potentes (aprender de las estadísticas del lenguaje real) es el que los hace absorber los prejuicios de ese lenguaje.
¿Qué tipo de sesgos aparecen?
Los embeddings pueden aprender, entre otros:
- Sesgos de género: «doctor» más cerca de «man», «nurse» más cerca de «woman».
- Sesgos raciales: asociaciones injustas entre grupos y adjetivos negativos.
- Sesgos culturales: profesiones, roles y adjetivos ligados a ciertos colectivos.
- Sesgos históricos: palabras que reflejan desigualdades del pasado.
Estos sesgos no los inventa el modelo. Los hereda del texto. Si entrenas con millones de páginas de internet, aprendes lo que internet piensa. Y eso incluye prejuicios.
¿Por qué ocurre esto?
Porque los embeddings capturan las estadísticas del lenguaje, y el lenguaje refleja cultura, historia, desigualdad, estereotipos y sesgos sociales. Los modelos no tienen moral: solo aprenden patrones. Si un patrón está en los datos, acaba en los vectores.
¿Cómo se detectan los sesgos?
Una técnica clásica es medir direcciones semánticas en el espacio vectorial. Igual que existe una dirección «hombre → mujer», pueden trazarse ejes como «career → family» (carrera → familia) o «science → arts» (ciencia → arte).
La prueba es sencilla: proyectas una palabra sobre ese eje y ves hacia qué lado cae.

Si palabras que deberían ser neutrales (como una profesión) se alinean demasiado con un extremo del eje, hay sesgo. El ejemplo histórico más citado:
«programmer» queda más cerca de «man» que de «woman».
El modelo no inventó eso. Lo aprendió del texto.
¿Cómo se mitigan los sesgos?
Existen varias técnicas:
- Debiasing geométrico: ajustar o neutralizar las direcciones problemáticas del espacio vectorial.
- Regularización durante el entrenamiento.
- Reentrenamiento con datos balanceados.
- Filtrado del corpus.
- Embeddings neutrales para palabras que no deberían tener carga de género o grupo.
Pero ninguna solución es perfecta. Puedes maquillar la geometría y aun así dejar rastros del sesgo original. Al final es un recordatorio incómodo: el sesgo es un problema social, no solo técnico.
El puente hacia los embeddings modernos
GloVe y Word2Vec fueron los primeros en demostrar que el significado puede representarse como geometría. A partir de ahí, cada modelo añadió una pieza:
- FastText añadió las subpalabras, para entender también palabras nuevas o mal escritas.
- Transformers añadieron contexto dinámico.
- Los modelos modernos generan embeddings por token, no por palabra, con un significado que cambia según la frase.
- Y aparecieron técnicas de mitigación parcial de sesgos.
Pero todos ellos se apoyan en la intuición que nació aquí.
En resumen
GloVe es el modelo que llevó los embeddings al siguiente nivel: aprende de estadísticas globales, captura relaciones amplias, produce analogías estables, complementa a Word2Vec y es la base de los modelos modernos.
Pero también nos enseñó algo importante:
Los embeddings no solo capturan significado. También capturan los sesgos del mundo.
Entender esto es esencial para construir una IA responsable.