

Autoencoders
La red neuronal que aprende a mirarse en el espejo
Cómo una máquina aprende a comprimir, reconstruir y entender la esencia de los datos.
En Deep Learning hay modelos que clasifican, otros que predicen, otros que generan…
Y luego están los Autoencoders, que hacen algo mucho más curioso:
Aprenden a copiar.
Pero copiando… aprenden a entender.
Puede sonar extraño. ¿Qué sentido tiene entrenar una red para que reproduzca exactamente la misma entrada que le das? La clave no está en qué hace, sino en cómo lo hace.
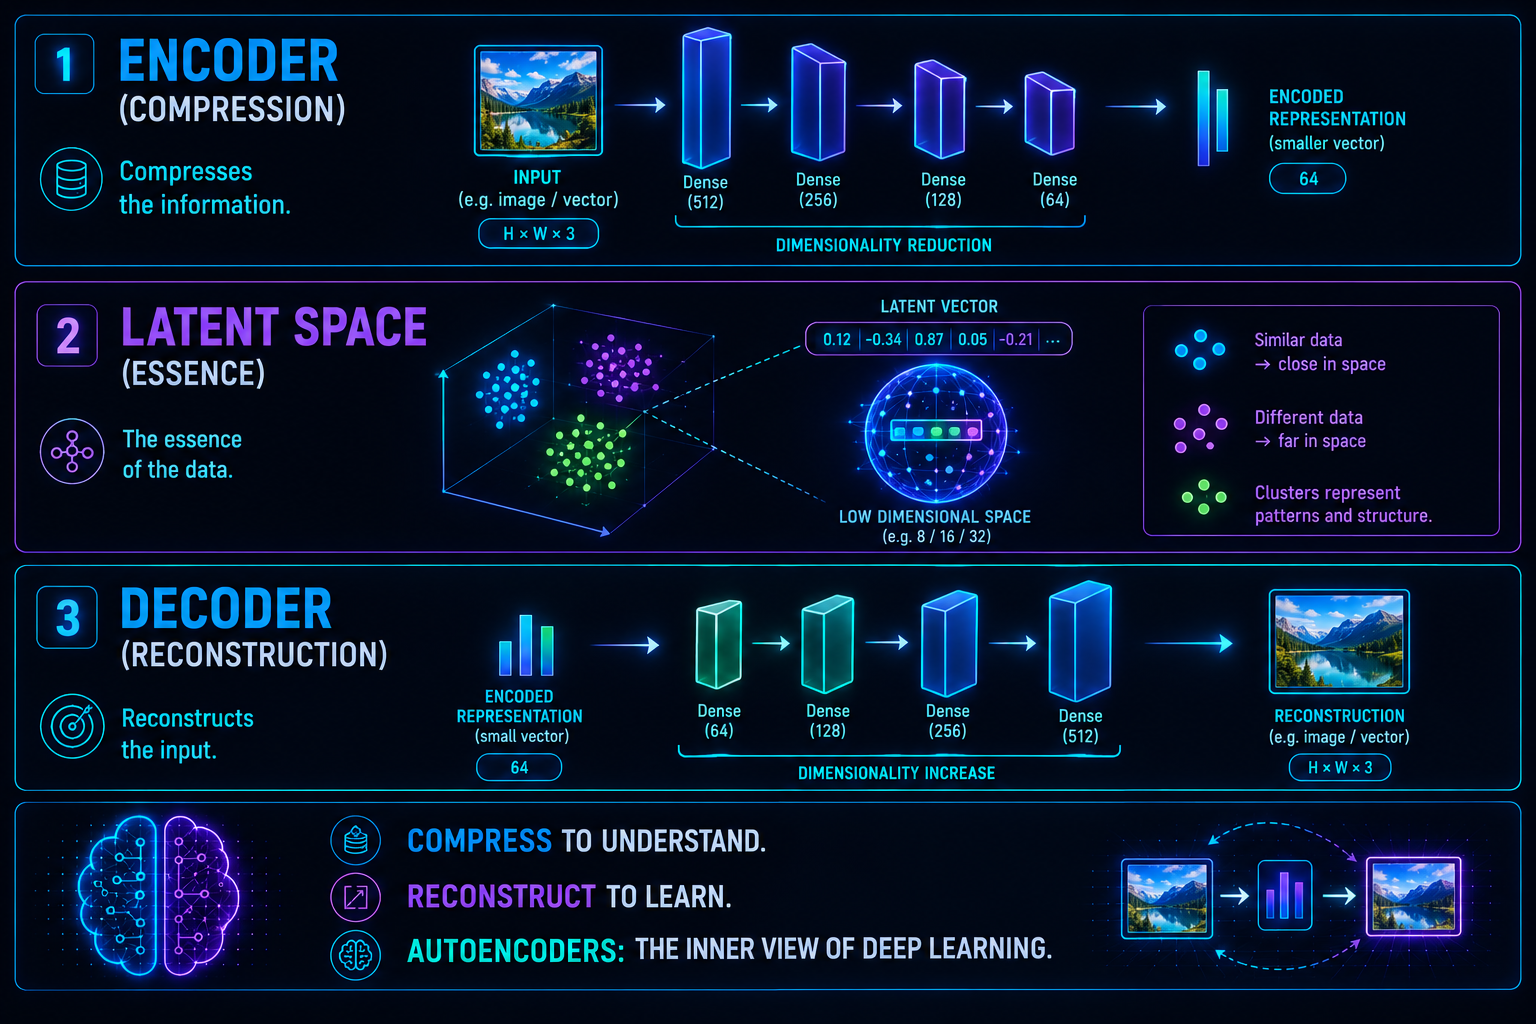
La idea central: comprimir para entender
Un Autoencoder tiene dos partes:
- Encoder → comprime los datos.
- Decoder → los reconstruye.
Entre ambos hay un punto crítico: un espacio pequeño, estrecho, comprimido, llamado latent space. Ahí es donde ocurre la magia.
La red recibe un dato (una imagen, un vector, un sonido), lo aplasta, lo reduce, lo exprime hasta dejarlo en unos pocos números… y luego intenta reconstruirlo a partir de esa versión comprimida.
Si lo logra, significa que ha aprendido la esencia del dato.
Un ejemplo para verlo. Es como pedirle a alguien que resuma un libro entero en una sola frase, y luego reconstruya el libro completo a partir de esa frase. Si puede hacerlo, no es porque memorizara las páginas: es porque entendió de verdad de qué iba el libro. El Autoencoder hace exactamente eso, pero con imágenes, sonidos o vectores.
¿Cómo funciona un Autoencoder?
El proceso es simple pero profundo:
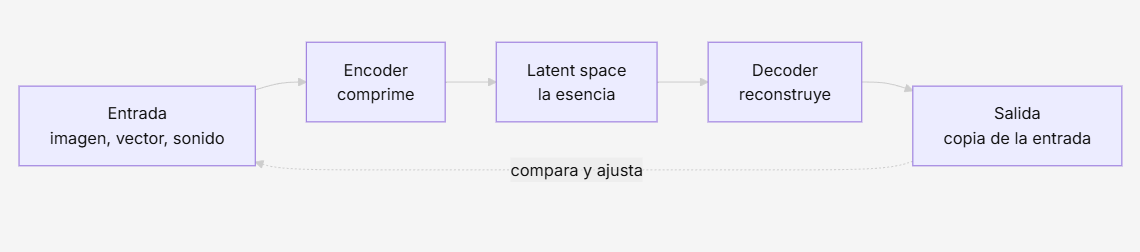
- Entrada. Le das una imagen, un vector, un texto codificado…
- Encoder. La red reduce la información a un vector pequeño: el latent space, la esencia comprimida.
- Decoder. A partir de ese vector, intenta reconstruir la entrada original.
- Pérdida. Compara la reconstrucción con la entrada real y ajusta pesos para mejorar la copia.
Y repite. Miles de veces. Hasta que aprende a comprimir sin perder lo importante.
¿Por qué es tan poderoso este mecanismo?
Porque al obligar a la red a comprimir, la obligas a entender.
Un Autoencoder no memoriza, no copia píxel a píxel, no guarda la imagen en su memoria. Tiene que descubrir qué partes son esenciales, qué patrones se repiten, qué estructura interna tienen los datos y qué se puede descartar sin perder significado.
Es como aprender a dibujar un rostro: no memorizas cada poro, memorizas la forma, la proporción, la esencia.
La intuición: aprender a mirar
Un Autoencoder es una red que aprende a mirarse en el espejo. Se observa a sí misma y se pregunta:
«¿Qué parte de esta imagen es realmente importante?»
«¿Qué puedo comprimir sin perder identidad?»
«¿Qué define este dato?»
Y al hacerlo, aprende representaciones profundas. Representaciones que luego sirven para detectar anomalías, reducir dimensionalidad, generar datos nuevos, limpiar ruido, crear embeddings o preentrenar modelos más grandes.
Es una herramienta de comprensión, no de clasificación.
El latent space: el corazón del Autoencoder
Ese vector comprimido -a veces de 2, 10 o 128 dimensiones- es un mapa. Un mapa donde las imágenes similares quedan cerca, las distintas quedan lejos, los conceptos se organizan solos y aparecen relaciones inesperadas.
Es como ver cómo la red organiza el mundo en su cabeza.
Si entrenas un Autoencoder con caras, el latent space aprende por su cuenta a distinguir sonrisa frente a seriedad, luz frente a sombra, la forma del rostro, la orientación, el estilo… sin que nadie se lo diga.
Variantes importantes
Aunque el Autoencoder clásico es simple, existen versiones más potentes:
| Variante | Qué la hace especial | Para qué se usa |
|---|---|---|
| Denoising Autoencoder | Recibe un dato con ruido y aprende a reconstruir la versión limpia | Eliminar ruido, restaurar datos dañados |
| Sparse Autoencoder | Fuerza al latent space a ser muy pequeño o muy disperso | Extraer las características más esenciales |
| Variational Autoencoder (VAE) | No solo comprime: genera datos nuevos | Generación de imágenes, uno de sus pilares |
¿Por qué es relevante para embeddings?
Porque un Autoencoder es, en esencia, una máquina de representaciones. Y un embedding es exactamente eso: una representación comprimida que captura significado.
Los Autoencoders fueron uno de los primeros métodos capaces de aprender representaciones profundas sin supervisión. Son el puente natural hacia Word2Vec, GloVe, los embeddings modernos, los Transformers y los modelos generativos.
En resumen
Un Autoencoder es una red que aprende a comprimir y reconstruir datos. Pero en ese proceso aprende algo mucho más valioso: la estructura interna del mundo que observa.
Es una herramienta para entender, no para clasificar. Para descubrir patrones, no para etiquetar. Para aprender significado, no para memorizar.
Y es el primer paso hacia los embeddings, el lenguaje vectorial que usan todas las redes modernas.