

RNN básicas + bidireccionales
Las redes que intentaron recordar… antes de que la atención lo cambiara todo
Cómo funcionan las RNN, por qué fueron revolucionarias y cómo las versiones bidireccionales ampliaron su capacidad de entender secuencias.
Hasta ahora hemos visto modelos que comprimen (Autoencoders) y modelos que capturan significado geométrico (Word2Vec, GloVe).
Hoy entramos en una familia distinta: las redes que procesan secuencias.
Antes de los Transformers, antes de la atención, antes de los LLM… las RNN fueron el primer intento serio de que una red neuronal recordara.

La idea central: procesar información paso a paso
Una RNN (Recurrent Neural Network) es una red diseñada para trabajar con datos donde el orden importa:
- texto
- audio
- series temporales
- señales de sensores
La intuición es sencilla:
Una RNN procesa la secuencia elemento a elemento y va guardando un estado interno que resume todo lo que ha visto hasta ese momento.
Ese estado es su memoria.
Una forma de imaginarlo. Piensa en cómo lees esta frase. No entiendes cada palabra de forma aislada: cargas lo que ya leíste y lo usas para interpretar lo que viene. Cuando llegas al punto final, tu comprensión es la suma de todo el recorrido. Una RNN hace exactamente eso: lee, actualiza su idea, y sigue.
¿Qué hace diferente a una RNN?
Una red normal recibe una entrada y produce una salida, y ahí termina. Una RNN añade un ingrediente clave: se pasa información a sí misma de un paso al siguiente.
En cada paso hace cuatro cosas:
- Recibe un elemento de la secuencia (una palabra, un número, un vector).
- Actualiza su estado interno combinando la entrada actual con lo que ya recordaba.
- Produce una salida (opcional).
- Avanza al siguiente elemento, llevándose la memoria consigo.
Ese estado interno se retroalimenta en cada paso. Por eso se llama recurrente.
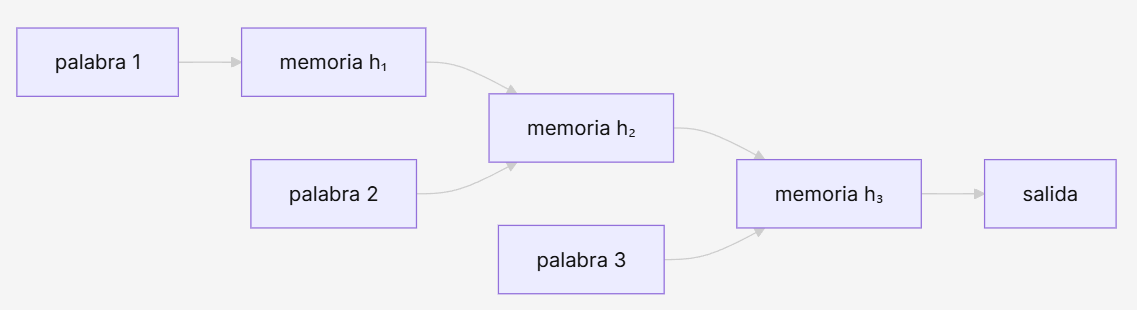
Fíjate en la cadena de memorias: cada estado hereda al anterior. Esa flecha que va de $h_1$ a $h_2$ a $h_3$ es toda la magia (y también, como veremos, todo el problema).
Matemáticamente, ¿qué ocurre?
En cada paso $t$, la nueva memoria se calcula así:
Donde:
- $x_t$ es la entrada actual
- $h_{t-1}$ es la memoria anterior
- $h_t$ es la nueva memoria
- $W$ y $U$ son matrices de pesos que la red aprende
Y la salida, cuando la hay, sale de esa memoria:
Es un mecanismo simple… pero sorprendentemente potente. Toda la «inteligencia» está en cómo mezcla lo nuevo ($x_t$) con lo viejo ($h_{t-1}$).
¿Qué pueden hacer las RNN?
Con esa memoria paso a paso, las RNN abrieron la puerta a tareas que antes eran muy difíciles:
- predecir la siguiente palabra
- clasificar secuencias
- generar texto
- analizar sentimiento
- modelar series temporales
- detectar patrones en datos secuenciales
Fueron la base de los primeros modelos de lenguaje.
El problema: recordar es difícil
Las RNN básicas tienen un defecto grave:
Les cuesta muchísimo recordar información durante muchos pasos.
El motivo es técnico pero se entiende bien con una imagen. Cuando la red aprende, tiene que «propagar» la señal de error hacia atrás a través de toda la cadena de memorias. Y al multiplicar muchas veces, pasa una de dos cosas:
| Problema | Qué ocurre | Consecuencia |
|---|---|---|
| Vanishing gradient | los gradientes se vuelven diminutos | la red olvida lo que pasó al principio |
| Exploding gradient | los gradientes se disparan | el entrenamiento se vuelve inestable |
Un ejemplo de por qué duele. Imagina la frase:
«Nací en Francia… (treinta palabras después) …por eso hablo con fluidez ______.»
Para completar el hueco con «francés», la red tiene que recordar la primera palabra treinta pasos atrás. Una RNN básica probablemente ya la ha olvidado. Por eso funcionan bien con secuencias cortas, pero fallan con frases largas o contextos complejos.
RNN bidireccionales: mirar hacia adelante y hacia atrás
Una RNN normal solo ve el pasado. Pero en el lenguaje, el futuro también importa.
Mira este ejemplo:
«Me senté en el banco a descansar.»
«Fui al banco a sacar dinero.»
La palabra banco significa cosas distintas, y la clave no está antes, sino en las palabras que vienen después. Una RNN que solo lee de izquierda a derecha llega a «banco» sin saber todavía cuál de los dos sentidos es.
Para resolverlo nacieron las RNN bidireccionales (BiRNN).
¿Cómo funciona una RNN bidireccional?
Una BiRNN no tiene una red, sino dos:
- una que procesa la secuencia hacia adelante (→)
- otra que la procesa hacia atrás (←)
Y luego combina ambas memorias para cada palabra.

Es como leer la frase dos veces: una de izquierda a derecha y otra de derecha a izquierda. Así, cada palabra se entiende con contexto pasado y futuro a la vez.
¿Por qué fueron tan importantes?
Las BiRNN supusieron un salto enorme porque:
- capturan el contexto completo de cada palabra
- resuelven mucho mejor las ambigüedades
- rinden mejor en tareas clásicas de NLP
- fueron la base de modelos como ELMo
Antes de los Transformers, las BiRNN eran prácticamente el estándar para entender lenguaje.
RNN vs BiRNN: diferencias claras
| Modelo | Qué ve | Ventajas |
|---|---|---|
| RNN | solo el pasado | simple y rápida |
| BiRNN | pasado + futuro | mejor comprensión semántica |
La regla práctica: si necesitas la frase entera antes de decidir (traducción, análisis de sentimiento, etiquetado), la BiRNN gana. Si tienes que predecir en tiempo real, palabra a palabra, sin conocer el futuro (como generar texto), solo puedes usar la versión hacia adelante.
El puente hacia LSTM, GRU y Transformers
Las RNN básicas fueron el primer intento de memoria. Las BiRNN ampliaron el contexto. Pero ambas seguían arrastrando el problema de los gradientes.
Por eso fueron apareciendo mejoras:
- LSTM → memoria con puertas que deciden qué recordar y qué olvidar
- GRU → una versión más simple y ligera de la LSTM
- Attention → memoria dinámica que mira directamente a lo relevante
- Transformers → paralelización total y contexto global
Las RNN son el origen de todo. Los Transformers, la evolución final.

En resumen
Las RNN fueron el primer modelo capaz de procesar secuencias con memoria: actualizan un estado interno, recuerdan lo que han visto y generan salidas paso a paso.
Las RNN bidireccionales ampliaron esa memoria mirando hacia adelante y hacia atrás, capturando el contexto completo y mejorando la comprensión del lenguaje.
Pero también nos dejaron una lección:
Recordar a largo plazo es difícil. Y esa dificultad es justo la que impulsó todo lo que vino después, hasta llegar a los Transformers.