

Reducción de Dimensionalidad: PCA + SVD
El algoritmo que aplana el universo sin perder su esencia
Cómo resumir miles de variables en unas pocas sin destruir la información que de verdad importa.
Hasta ahora hemos trabajado con datos cómodos, de esos que caben en una hoja: gasto y frecuencia, productos dentro de una cesta, puntos sobre un plano. Dos dimensiones, un gráfico, y todo bajo control. El problema es que el mundo real rara vez es tan amable.
El mundo real es multidimensional. Un cliente no se describe con dos números, sino con decenas de comportamientos. Un producto puede tener cientos de características. Un usuario deja miles de señales. Una imagen son diez mil píxeles, y un texto vectorizado puede ser un vector de cincuenta mil palabras. Cuanto más rico es el dato, más dimensiones arrastra.
Y ahí, en cuanto las dimensiones se disparan, aparece un enemigo silencioso: la maldición de la dimensionalidad. Suena a título de novela, pero es muy real. A medida que sumas dimensiones, los datos se vuelven dispersos (cada punto queda «solo» en un espacio enorme y casi vacío), los modelos se vuelven lentos, las distancias dejan de significar lo que creemos, y la intuición humana, que ya sufre en 3D, simplemente se apaga.
Necesitamos una forma de aplanar ese universo sin destruirlo. De quedarnos con lo esencial y tirar el resto. Ahí entra PCA. Y detrás de PCA, trabajando en silencio como el motor bajo el capó, está SVD.
El problema: demasiadas dimensiones, demasiado ruido
Imagina un dataset con 200 variables por cliente. No puedes dibujarlo. No puedes visualizarlo. Y desde luego no puedes hacerte una imagen mental de él. Nuestra cabeza no está preparada para «ver» en 200 dimensiones.
Pero hay una buena noticia escondida en ese caos: muchas de esas variables dicen prácticamente lo mismo. Están correlacionadas. El gasto mensual y el gasto anual suben y bajan juntos. Las visitas por semana y las visitas por mes cuentan casi la misma historia. Los clicks y el tiempo en página tienden a ir de la mano. Si dos variables se mueven siempre a la vez, ¿de verdad necesitas las dos?
PCA parte justo de esa idea y hace algo que parece magia:
Encuentra las direcciones en las que tus datos varían más y te permite proyectarlos en un espacio mucho más pequeño sin perder lo esencial.
Es como mirar una escultura. Si la miras desde el ángulo equivocado, ves una silueta plana y confusa. Pero hay un ángulo perfecto desde el que, de golpe, entiendes su forma completa sin necesidad de dar la vuelta entera. PCA busca ese ángulo perfecto para tus datos.
PCA: el algoritmo que busca las direcciones importantes
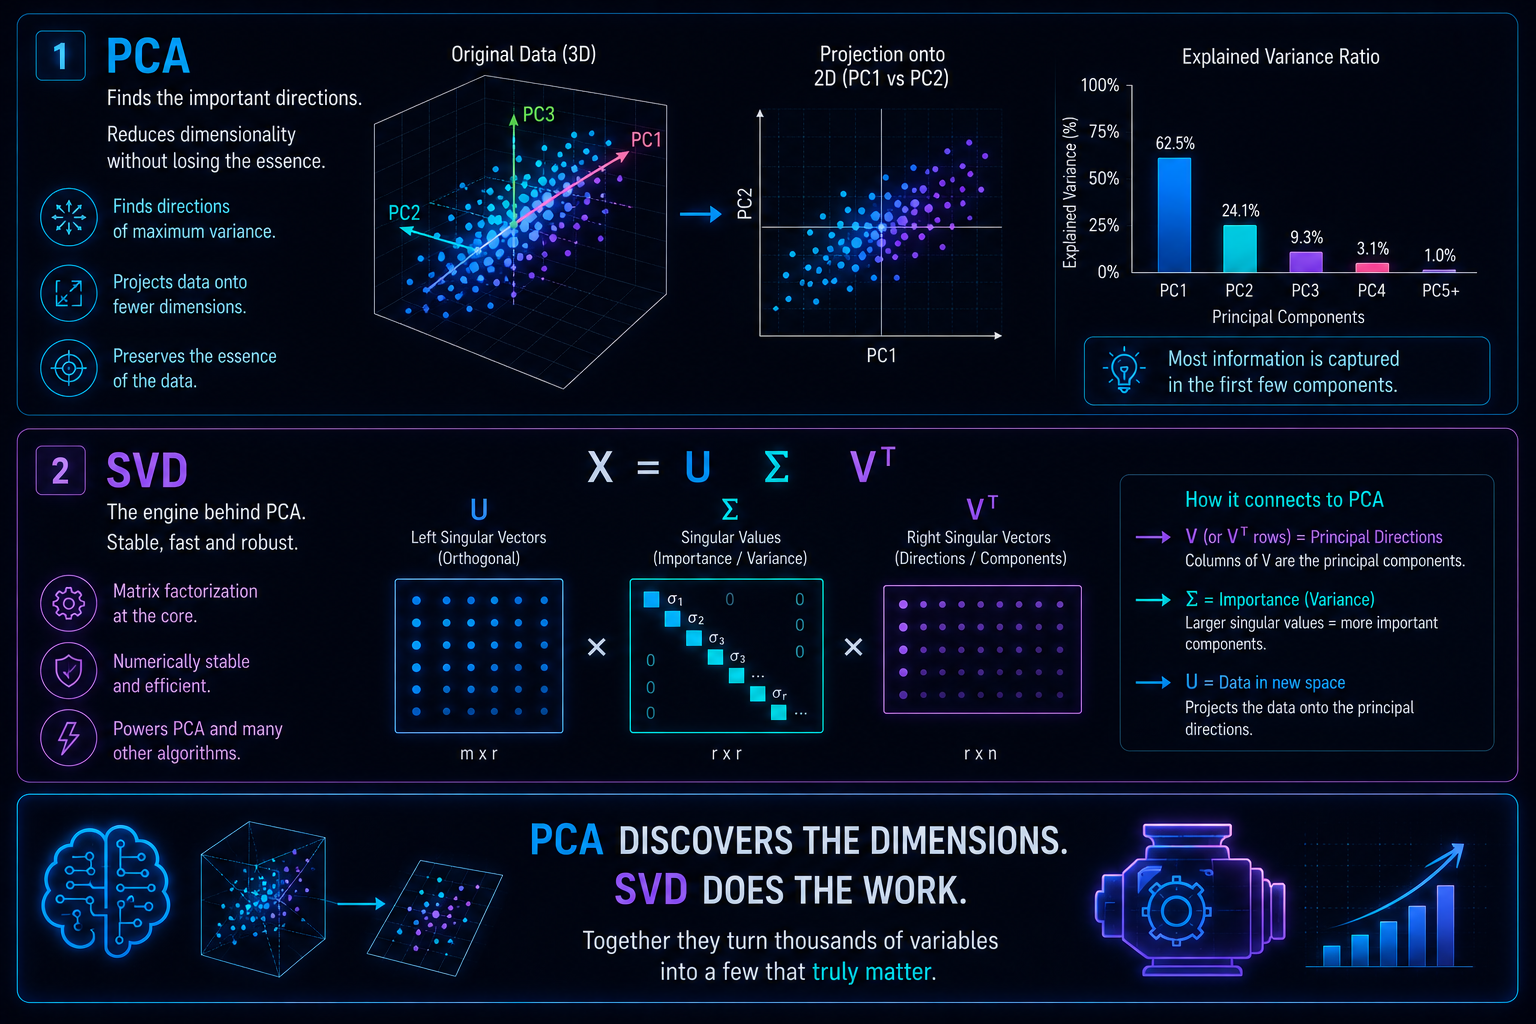
PCA significa Principal Component Analysis (Análisis de Componentes Principales), y su misión se resume en una frase: encontrar los ejes que capturan la mayor variación posible en tus datos.
La clave está en el orden. PCA no encuentra ejes al azar, sino por importancia. La primera dirección (el primer componente) es aquella en la que los datos se extienden más, donde hay más «vida» y más diferencias entre observaciones. La segunda captura la mayor variación de lo que queda, siempre perpendicular a la primera. La tercera, lo que sobra después de esas dos. Y así sucesivamente.
Lo interesante es que casi toda la información suele concentrarse en los primeros componentes. Los últimos apenas aportan: son, en su mayoría, ruido.
La intuición visual
Piensa en una nube de puntos flotando en 3D, alargada como un balón de rugby. PCA la observa y se pregunta: ¿en qué dirección se estira más esta nube? Esa es la primera dirección. Luego busca la segunda dirección más ancha, perpendicular a la anterior. Y después la tercera, perpendicular a las dos.
Si el balón es muy plano y muy alargado, casi toda su forma vive en dos direcciones. Podrías aplastarlo de 3D a 2D y apenas notarías la diferencia. Eso es exactamente lo que hace PCA: proyecta la nube sobre las direcciones que importan y descarta las que solo aportan grosor irrelevante.
Qué hace PCA, paso a paso
Por dentro, el procedimiento clásico sigue esta secuencia:
- Centra los datos, restando la media de cada variable para que todo gire en torno al origen.
- Calcula la matriz de covarianza, que resume cómo se relacionan las variables entre sí.
- Encuentra sus autovectores (eigenvectors) y autovalores (eigenvalues): las direcciones y la cantidad de varianza que hay en cada una.
- Ordena esos autovectores por importancia, de mayor a menor varianza.
- Proyecta los datos sobre esos nuevos ejes.
Y aquí llega el giro interesante: en la práctica, casi nadie calcula PCA de esta forma. Se usa SVD.
SVD: el motor secreto detrás de PCA
SVD significa Singular Value Decomposition (Descomposición en Valores Singulares). Es una herramienta matemática que toma cualquier matriz, por grande y desordenada que sea, y la rompe en tres piezas limpias:
Cada pieza tiene un papel:
- U contiene las direcciones asociadas a las observaciones.
- Σ (sigma) contiene la importancia de cada dirección, es decir, cuánta información carga.
- V contiene las bases del nuevo espacio, los ejes sobre los que proyectaremos.
Y aquí está la conexión que lo une todo: los componentes principales de PCA son exactamente las columnas de V, y las varianzas explicadas se obtienen de los valores de Σ al cuadrado.
Dicho de otro modo: PCA es, literalmente, SVD con un nombre más amable. Uno es el concepto que explicas en clase; el otro es la maquinaria que lo ejecuta cuando pulsas «correr».
¿Por qué SVD en lugar de los autovectores?
Porque cuando pasas de la pizarra a los datos reales, SVD gana por goleada. Es más estable numéricamente (comete menos errores de redondeo), es más rápido y robusto, y sigue funcionando en situaciones incómodas: cuando la matriz de covarianza es gigantesca, cuando tienes más variables que muestras (algo habitual en genómica o en texto), o cuando los datos están mal condicionados. En el trabajo del día a día, PCA y SVD son, a efectos prácticos, lo mismo.
Un ejemplo en nuestra tienda
Volvamos a algo concreto. Imagina que ahora describes a cada cliente con 50 variables: gasto, frecuencia, visitas, clicks, tiempo en página, categorías favoritas, ratio de conversión, y una larga lista más. Cincuenta números por persona. Imposible de visualizar, difícil de agrupar, agotador de analizar.
Aplicas PCA y ocurre algo revelador. Descubres, por ejemplo, que:
- 3 componentes explican el 85% de toda la variación.
- 2 componentes ya capturan el 70%.
- 1 solo componente recoge el 40%.
De repente, esas 50 dimensiones se comprimen en 2 o 3. Y con 2 dimensiones, puedes dibujar a tus clientes en un gráfico normal. Puedes agruparlos, verlos como nubes, detectar bloques que se separan del resto. Patrones que estaban enterrados bajo 50 columnas de Excel salen por fin a la superficie.
¿Qué representa cada componente?
Aquí es donde PCA deja de ser solo una herramienta de compresión y se vuelve interesante conceptualmente. Cada componente no es una de tus variables originales, sino una mezcla ponderada de todas ellas. Por ejemplo:
Si te fijas en los pesos, este componente da mucha importancia al gasto y a la frecuencia. Podrías leerlo casi como una etiqueta: «este eje mide el nivel general de actividad del cliente». Un cliente con un valor alto en PC1 es alguien que gasta, vuelve y navega mucho.
Por eso PCA hace algo más que reducir dimensiones: crea variables nuevas que capturan conceptos. Conceptos que a menudo ni sabíamos que estaban ahí, escondidos entre columnas que mirábamos por separado.
Ventajas y desventajas
Como toda herramienta, PCA es excelente para unas cosas y torpe para otras. Merece la pena tenerlo claro antes de aplicarlo.
| Ventajas | Desventajas |
|---|---|
| Reduce el ruido de los datos | Los componentes no siempre son fáciles de interpretar |
| Reduce la dimensionalidad | Es lineal: no captura relaciones curvas o complejas |
| Facilita la visualización | Puedes perder información si reduces demasiado |
| Acelera el entrenamiento de modelos | Requiere estandarizar los datos antes de aplicarlo |
| Elimina la correlación entre variables | |
| Descubre estructuras ocultas |
¿Cuándo usar PCA (y cuándo no)?
Úsalo cuando tengas muchas variables, cuando sospeches que hay correlación entre ellas, cuando quieras visualizar datos complejos en 2D o 3D, cuando necesites acelerar un modelo pesado, o cuando busques limpiar ruido y sacar a la luz la estructura que se esconde debajo.
Evítalo cuando tus datos sean fuertemente no lineales (PCA solo entiende de líneas rectas, así que una relación en forma de espiral o de curva se le escapa), cuando necesites interpretabilidad absoluta de cada variable, o cuando tus variables tengan escalas muy distintas y no las hayas estandarizado antes. Este último punto es importante: si una variable va de 0 a 1 y otra de 0 a 100.000, la segunda dominará el análisis solo por su tamaño, no por su relevancia real.
En resumen
PCA es el algoritmo que aplana el universo. Elimina el ruido, encuentra las direcciones que de verdad importan, resume cientos de variables en apenas unas cuantas y nos permite visualizar lo que antes era invisible. Y SVD es el motor matemático silencioso que hace todo eso posible de forma rápida y estable.
Si el clustering consistía en descubrir formas, y las reglas de asociación en descubrir relaciones, PCA va un paso más allá: consiste en descubrir dimensiones.
Es el algoritmo que mira tu dataset lleno de columnas, respira hondo y te dice:
«No necesitas 200 variables. Con 3 me basta.»