

Reducción de Dimensionalidad: LDA
El algoritmo que separa universos
Cómo encontrar las direcciones que mejor distinguen unas clases de otras, justo cuando PCA se queda corto.
En el capítulo anterior conocimos a PCA, el algoritmo que aplana el universo buscando las direcciones donde los datos varían más. Es una herramienta brillante, pero tiene un punto ciego que conviene entender bien antes de seguir: PCA no sabe nada de clases. No sabe quién es quién.
Y esto, que suena a detalle técnico, es en realidad una limitación enorme.
Si tienes clientes fieles y ocasionales, a PCA le da igual: no intenta separarlos. Si tienes fotos de gatos y perros, PCA no intenta distinguirlos. Si tienes transacciones fraudulentas y normales, PCA no hace ningún esfuerzo por alejarlas. PCA solo persigue una cosa: la variación. Busca dónde hay más «vida» en los datos, sin preguntarse jamás a qué grupo pertenece cada punto.
Y aquí está la trampa: variación no siempre significa separación. La dirección donde tus datos más se dispersan puede ser, precisamente, la que mezcla tus dos grupos en un mismo revoltijo. PCA los aplastaría juntos tan contento, porque para él solo son puntos.
Ahí es donde entra LDA, con una filosofía completamente distinta.
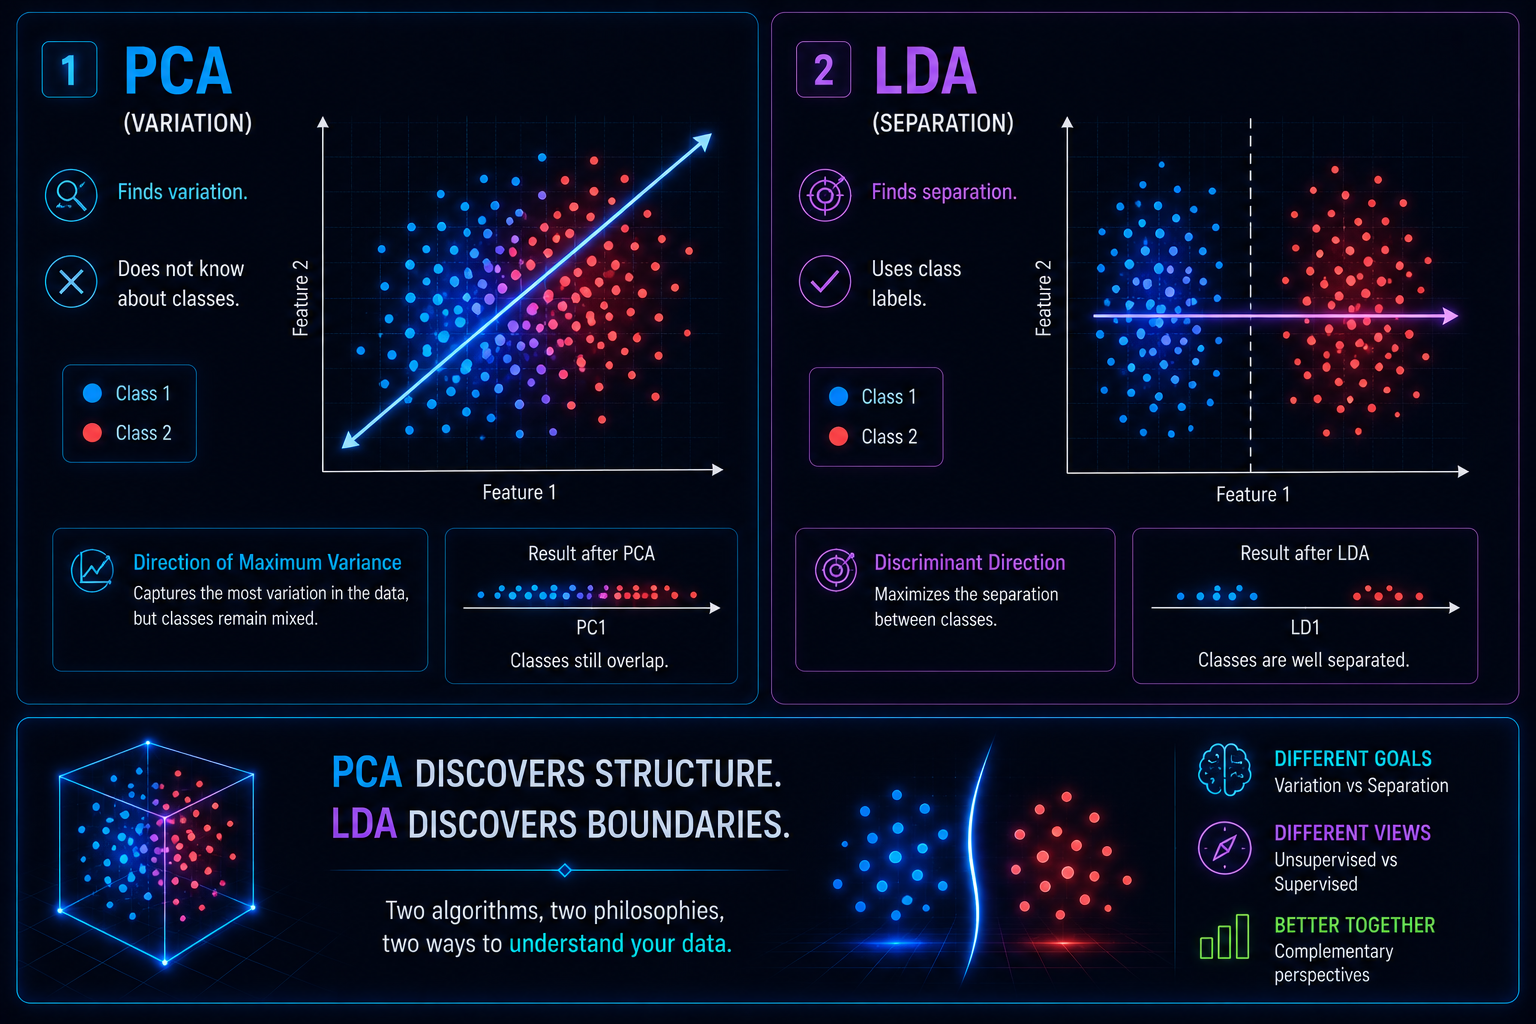
¿Qué es LDA?
LDA son las siglas de Linear Discriminant Analysis, y su misión no se parece en nada a la de PCA. Donde PCA pregunta:
«¿Dónde varían más los datos?»
LDA pregunta:
«¿Dónde se separan mejor las clases?»
No es un matiz. Es un cambio de mentalidad total. PCA trabaja a ciegas, sin etiquetas, explorando la forma del conjunto. LDA trabaja con las respuestas delante: sabe qué punto es un cliente fiel y cuál es ocasional, y usa esa información para buscar el ángulo desde el que ambos grupos se ven lo más alejados posible.
Por eso decimos que PCA es no supervisado y LDA es supervisado. Uno improvisa sin partitura; el otro tiene la solución y busca la mejor forma de dibujarla.
La intuición: separar nubes
Imagina dos nubes de puntos flotando en un espacio de 50 dimensiones. Una nube azul son tus clientes fieles; una nube roja, los ocasionales. Están ahí, entremezcladas en un espacio imposible de visualizar.
PCA buscaría la dirección donde ambas nubes, tomadas como un todo, se extienden más. El problema es que esa dirección podría atravesar las dos nubes a lo largo, dejándolas superpuestas. Habrías reducido dimensiones, sí, pero seguirías sin poder distinguir un grupo del otro.
LDA hace justo lo contrario. Busca la dirección que consigue dos cosas a la vez:
- Que los centros de las dos nubes queden lo más lejos posible entre sí.
- Que los puntos de cada nube queden lo más apretados posible dentro de su propio grupo.
Es como buscar la línea perfecta para dividir dos grupos en un gráfico: esa recta que deja a los azules a un lado, a los rojos al otro, y con la menor mezcla posible en la frontera.
La idea matemática, sin dolor
Todo LDA se resume en optimizar una única razón, un cociente entre dos ideas enfrentadas:
Piénsalo como una balanza. Arriba tienes lo que quieres maximizar: la distancia entre los centros de las clases (que estén lejos). Abajo, lo que quieres minimizar: lo desperdigados que están los puntos dentro de cada clase (que estén compactos).
LDA busca la dirección que hace ese cociente lo más grande posible. Numerador arriba, denominador abajo: clases lejanas y grupos apretados. Cuando encuentra esa dirección, ha encontrado el ángulo desde el que tus grupos se distinguen mejor que desde ningún otro.
¿Qué produce LDA?
Aquí aparece una diferencia curiosa y muy práctica frente a PCA. LDA genera lo que llamamos componentes discriminantes, pero no puede producir tantos como quiera. El número está limitado por la cantidad de clases que tengas:
- 2 clases → LDA produce 1 componente
- 3 clases → LDA produce 2 componentes
- k clases → LDA produce k − 1 componentes
La regla es simple y no tiene excepciones: LDA nunca puede dar más componentes que el número de clases menos uno. Tiene sentido si lo piensas: para separar dos grupos basta con una línea; para separar tres, necesitas un plano definido por dos direcciones. La geometría de la separación marca el límite.
PCA vs LDA: la comparación que todo el mundo necesita
Puestos uno al lado del otro, las diferencias se ven de golpe:
| Característica | PCA | LDA |
|---|---|---|
| Tipo | No supervisado | Supervisado |
| Objetivo | Máxima variación | Máxima separación |
| Usa etiquetas | No | Sí |
| Componentes | Hasta n variables | Hasta k − 1 clases |
| Ideal para | Exploración | Clasificación |
Y si hubiera que resumirlo en una sola frase para no olvidarlo nunca:
PCA descubre estructura. LDA descubre fronteras.
Ejemplo en nuestra tienda
Volvamos a lo concreto. Imagina que clasificas a tus clientes en tres grupos: fieles, ocasionales y dormidos. Y que describes a cada uno con 40 variables: gasto, frecuencia, visitas, clics, tiempo en la web y una larga lista más.
Si aplicas PCA, obtienes 40 componentes, de los cuales los primeros 2 o 3 capturan la mayor parte de la variación. Útil para explorar, pero sin ninguna garantía de que esos ejes separen tus tres tipos de cliente.
Si aplicas LDA, en cambio, obtienes solo 2 componentes (porque tienes 3 clases, y 3 − 1 = 2). Pero esos dos componentes no son cualquier cosa: están optimizados precisamente para separar:
- fieles ↔ ocasionales
- fieles ↔ dormidos
- ocasionales ↔ dormidos
Cuando dibujas el gráfico LDA en 2D, los tres grupos aparecen limpiamente separados, cada uno en su zona. Algo que PCA, por muy bueno que sea, no te garantiza jamás, porque ni siquiera sabía que esos grupos existían.
¿Para qué sirve LDA en la vida real?
Su terreno natural es todo lo que tenga que ver con clasificar. Sirve de excelente paso previo para preparar los datos antes de entrenar modelos como SVM, regresión logística, KNN, árboles de decisión o redes neuronales pequeñas: al quedarte solo con las direcciones que separan clases, le entregas al modelo un problema mucho más limpio.
También es ideal para la visualización supervisada, cuando quieres ver de verdad cómo se separan tus clases en un plano de 2D. Y funciona muy bien como reducción de dimensionalidad con etiquetas: cuando tienes muchísimas variables pero, a la vez, sabes a qué grupo pertenece cada muestra. De paso, al descartar las direcciones irrelevantes y quedarse solo con las que discriminan, reduce el ruido y ayuda a evitar el overfitting.
Ventajas y desventajas
Como toda herramienta, LDA brilla en unas cosas y tropieza en otras.
| Ventajas | Desventajas |
|---|---|
| Aprovecha la información de las clases | Solo funciona si las clases están más o menos separadas |
| Produce componentes muy interpretables | Asume que las clases tienen distribución parecida (gaussiana) |
| Excelente para clasificación | No funciona bien si las clases son no lineales |
| Reduce dimensiones de forma óptima para separar | No sirve para clustering: necesita etiquetas sí o sí |
| Muy rápido y estable | Limitado a k − 1 componentes |
¿Cuándo usar LDA (y cuándo no)?
Úsalo cuando tengas etiquetas, quieras separar clases, necesites visualizar esos grupos en 2D, busques mejorar un modelo de clasificación, o tengas muchas variables y pocas muestras.
Evítalo cuando no tengas etiquetas (sin ellas, LDA simplemente no puede trabajar), cuando las clases se mezclen demasiado, cuando las fronteras entre grupos sean curvas o complejas (LDA solo entiende de líneas rectas, igual que PCA), o cuando necesites más componentes de los que la regla k − 1 te permite.
En resumen
LDA es el algoritmo que separa nubes. Encuentra fronteras donde PCA solo veía puntos, comprime dimensiones sin perder de vista quién es quién, y usa las etiquetas para descubrir las direcciones que de verdad distinguen unos grupos de otros. Convierte datos imposibles de mirar en gráficos donde las clases se ven, por fin, claramente separadas.
Si PCA consistía en descubrir dimensiones, LDA consiste en descubrir separaciones.
Es el algoritmo que mira tus clases, se remanga, y te dice:
«Déjame encontrar la dirección donde están más lejos.»