

LSTM + GRU
Las redes que aprendieron a recordar de verdad
Cómo las LSTM y las GRU resolvieron el problema de la memoria en secuencias y prepararon el camino hacia la atención y los Transformers.
En el capítulo anterior vimos cómo las RNN intentaron recordar… y cómo las versiones bidireccionales intentaron comprender.
Pero ambas tenían un enemigo que no podían vencer:
Recordar a largo plazo es difícil.
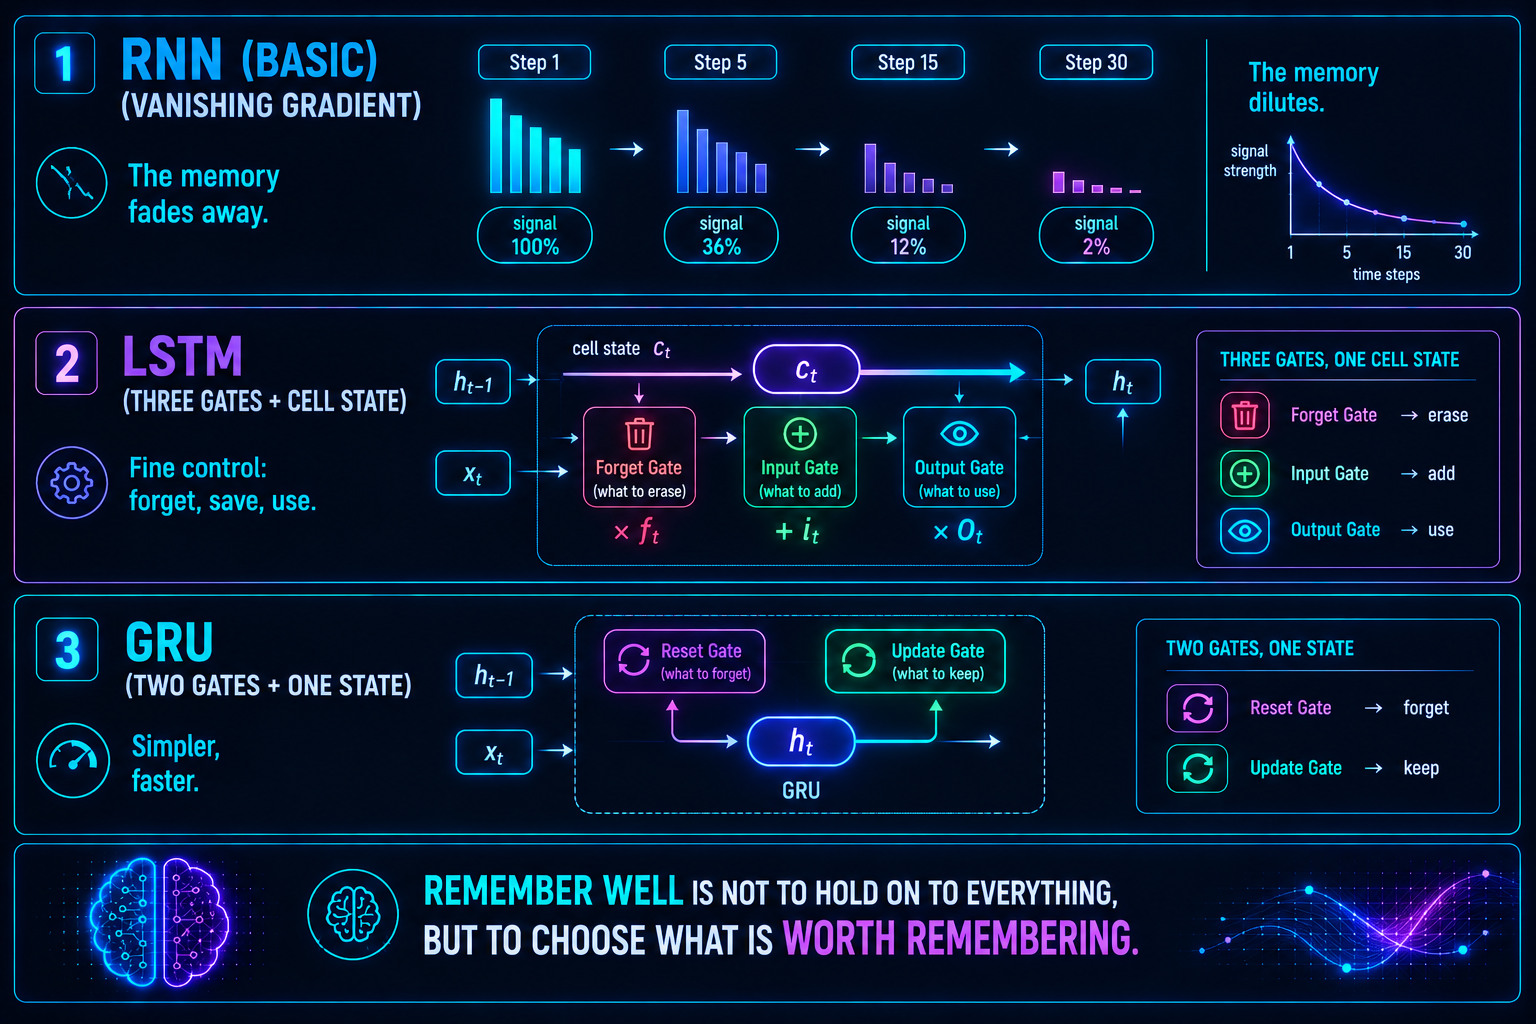
El vanishing gradient hacía que las RNN olvidaran información importante justo cuando más la necesitaban. Las LSTM y las GRU nacieron para resolver exactamente ese problema.
El problema que había que resolver
Una RNN básica actualiza su memoria así:
Cada paso mezcla lo nuevo ($x_t$) con lo viejo ($h_{t-1}$). El problema es que, cuando la secuencia es larga, esa mezcla repetida hace que la memoria antigua se diluya hasta desaparecer.
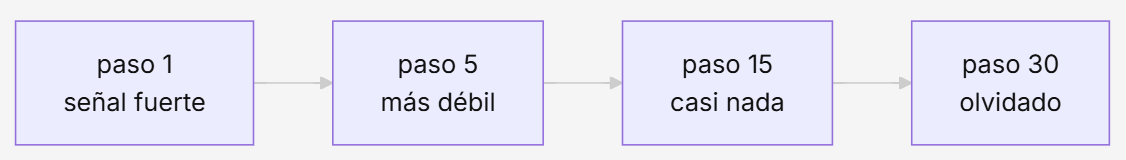
Una forma de imaginarlo. Es como intentar recordar una frase larga repitiéndola mentalmente, pero cada vez la repites un poco más bajito… hasta que ya no queda nada. La información del principio se apaga antes de llegar al final.
Las LSTM y las GRU propusieron una idea distinta:
«En vez de mezclar todo a ciegas, vamos a controlar qué recordar, qué olvidar y qué actualizar.»
Y eso lo cambió todo.
LSTM: Long Short-Term Memory
La LSTM es una RNN con puertas: pequeños mecanismos que deciden qué información entra, qué sale y qué se mantiene.
Tiene tres puertas principales.
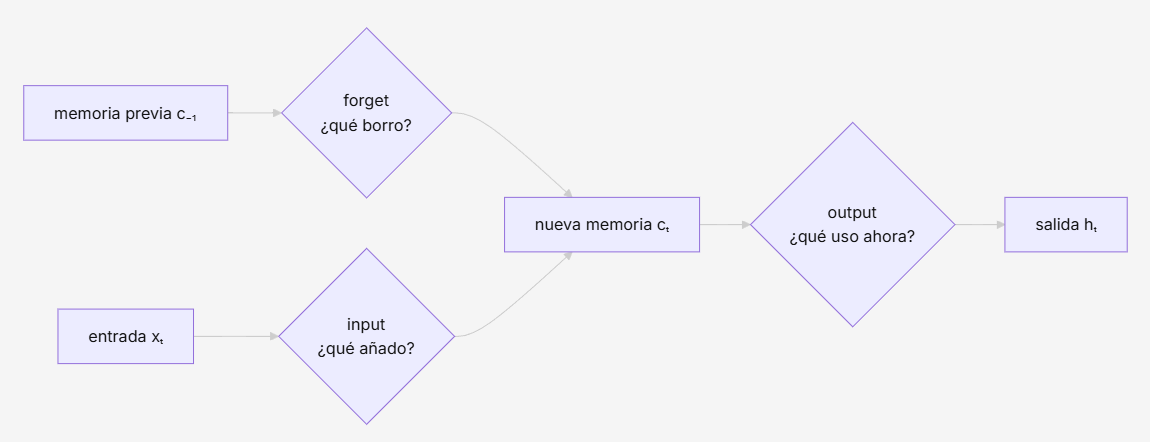
1. Puerta de olvido (forget gate). Decide qué parte de la memoria anterior debe desaparecer.
2. Puerta de entrada (input gate). Decide qué información nueva merece añadirse.
3. Puerta de salida (output gate). Decide qué parte de la memoria se usa para producir la salida en este paso.
Fíjate en la función $\sigma$ (la sigmoide): devuelve valores entre 0 y 1. Es literalmente un regulador: 0 significa «que no pase nada», 1 significa «que pase todo», y los valores intermedios dejan pasar una parte. Cada puerta es como un grifo que la red aprende a abrir o cerrar.
Y además, la LSTM mantiene un estado de celda $c_t$: la memoria «pura», que viaja a lo largo de toda la secuencia con muy poca distorsión. Esa es la clave de su éxito.
La intuición detrás de las LSTM
Piensa en cómo funciona tu propia memoria:
- hay cosas que olvidas a propósito
- cosas que decides recordar
- cosas que usas en el momento
- cosas que guardas para más tarde
La LSTM hace exactamente eso, pero con matemáticas. Es como tener un archivador con tres botones: OLVIDAR, GUARDAR y USAR.
Un ejemplo concreto. Retomemos la frase que rompía a las RNN básicas:
«Nací en Francia… (treinta palabras después) …por eso hablo con fluidez ______.»
Una LSTM puede abrir la puerta de entrada al leer «Francia», guardar ese dato en el estado de celda, mantener la puerta de olvido casi cerrada durante las treinta palabras intermedias (que no aportan nada relevante), y por fin usar esa memoria al llegar al hueco para responder «francés». Por eso las LSTM recuerdan información durante cientos de pasos donde una RNN normal ya se había perdido.
¿Por qué fueron revolucionarias?
Porque resolvieron el problema que las RNN no podían: manejar dependencias largas, contexto complejo, frases largas, relaciones distantes y hacerlo con estabilidad en el entrenamiento.
No es exageración decir que las LSTM fueron el estándar en NLP durante casi una década, desde la traducción automática hasta el reconocimiento de voz.
GRU: Gated Recurrent Unit
La GRU nació como una versión más simple de la LSTM. La idea era: ¿de verdad necesitamos tres puertas y dos estados de memoria separados?
Tiene solo dos puertas.
1. Puerta de actualización (update gate). Decide cuánto de la memoria anterior conservar frente a cuánta información nueva incorporar. Fusiona en un solo mecanismo el trabajo que en la LSTM hacían las puertas de olvido y entrada.
2. Puerta de reinicio (reset gate). Decide cuánto de la memoria anterior ignorar al calcular la nueva propuesta de memoria.
Además, la GRU combina el estado de celda y el estado oculto en uno solo. Menos piezas que mover significa que es más ligera, más rápida de entrenar y, en muchos casos, igual de eficaz.

LSTM vs GRU: ¿cuál es mejor?
Depende del caso, y en la práctica la diferencia suele ser pequeña.
| Modelo | Ventajas | Cuándo usarla |
|---|---|---|
| LSTM | más expresiva, más control fino sobre la memoria | secuencias muy largas, tareas complejas |
| GRU | más simple, más rápida, menos parámetros | datasets grandes, entrenamiento rápido, recursos limitados |
La regla práctica: si tienes mucho cómputo y una tarea que exige memoria muy fina, la LSTM te da control. Si quieres entrenar rápido y con menos datos o recursos, la GRU suele rendir igual o mejor. Muchos modelos modernos, cuando aún usan recurrencia, prefieren la GRU precisamente por ese equilibrio.
¿Qué resolvieron realmente?
Las LSTM y las GRU consiguieron algo que las RNN básicas no podían:
- ✔ domar el vanishing gradient
- ✔ evitar el exploding gradient
- ✔ recordar información a largo plazo
- ✔ estabilizar el entrenamiento
Por primera vez, una red neuronal podía sostener información importante durante toda la secuencia sin que se le escapara por el camino.
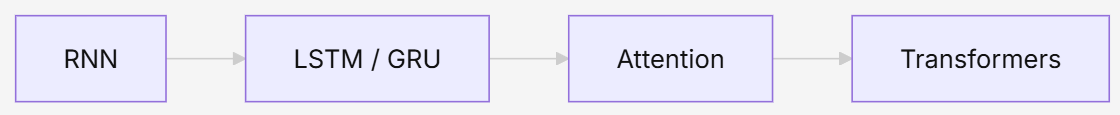
El puente hacia la atención y los Transformers
Las LSTM y las GRU fueron un salto enorme… pero seguían arrastrando limitaciones de fondo:
- procesan las secuencias paso a paso (no se pueden paralelizar bien)
- siguen dependiendo estrictamente del orden
- su memoria, aunque enorme, sigue siendo limitada
- son lentas con textos muy largos
Ahí es donde entraron dos ideas que lo cambiaron todo.
La atención dijo:
«¿Y si en vez de comprimir todo en una memoria, miramos directamente a lo relevante en cada momento?»
Los Transformers dijeron:
«¿Y si procesamos toda la secuencia en paralelo, sin ir palabra a palabra?»
Pero conviene recordarlo: sin las LSTM y las GRU, la atención nunca habría tenido dónde nacer.
En resumen
Las LSTM y las GRU fueron las primeras redes capaces de recordar de verdad: usan puertas para controlar qué olvidar, qué guardar y qué usar, resuelven el problema del vanishing gradient, capturan dependencias largas y fueron el estándar en NLP durante años.
Su gran aportación no fue solo técnica, sino conceptual:
Recordar bien no es aferrarse a todo, sino elegir qué merece la pena recordar.
Son el puente entre las RNN clásicas y los modelos modernos de lenguaje, y el último paso antes de que la atención lo reescribiera todo.