

Métodos Ensemble
El arte de combinar modelos para vencer al ruido, la varianza y la complejidad
Cómo varios modelos débiles, juntos, se convierten en uno extraordinariamente fuerte.
Hasta ahora hemos conocido algoritmos solitarios, artistas que trabajan por su cuenta. PCA aplana universos. LDA separa fronteras. LSA descubre significados. t‑SNE dibuja paisajes. Cada uno, a su manera, se basta a sí mismo.
Pero en el aprendizaje automático hay una familia entera que no cree en la soledad. Cree en la colaboración. Y su filosofía cabe en una sola frase:
Un modelo débil puede fallar. Pero cien modelos débiles, bien organizados, pueden ser imparables.
Bienvenido a los Métodos Ensemble.
La idea de fondo: por qué funciona la multitud
La intuición es casi humana, y por eso engancha tanto. Si le preguntas a una sola persona, puede equivocarse. Pero si le preguntas a cien personas distintas y haces un promedio, la respuesta suele acercarse mucho más a la verdad. Es el mismo fenómeno que hace que, en los concursos de «adivina cuántas canicas hay en el bote», el promedio de todo el público casi siempre gane a cualquier individuo.
Los ensembles explotan justo eso. Al juntar muchos modelos consiguen reducir la varianza (dejan de ponerse nerviosos ante el ruido), reducir el sesgo (capturan patrones que un modelo solo no vería), ganar robustez y, usados con cabeza, evitar el sobreajuste. En el fondo, no son más que comités de modelos que votan, discuten y se corrigen entre sí.
Y dentro de esta familia conviven dos grandes personalidades, dos formas opuestas de organizar el comité:
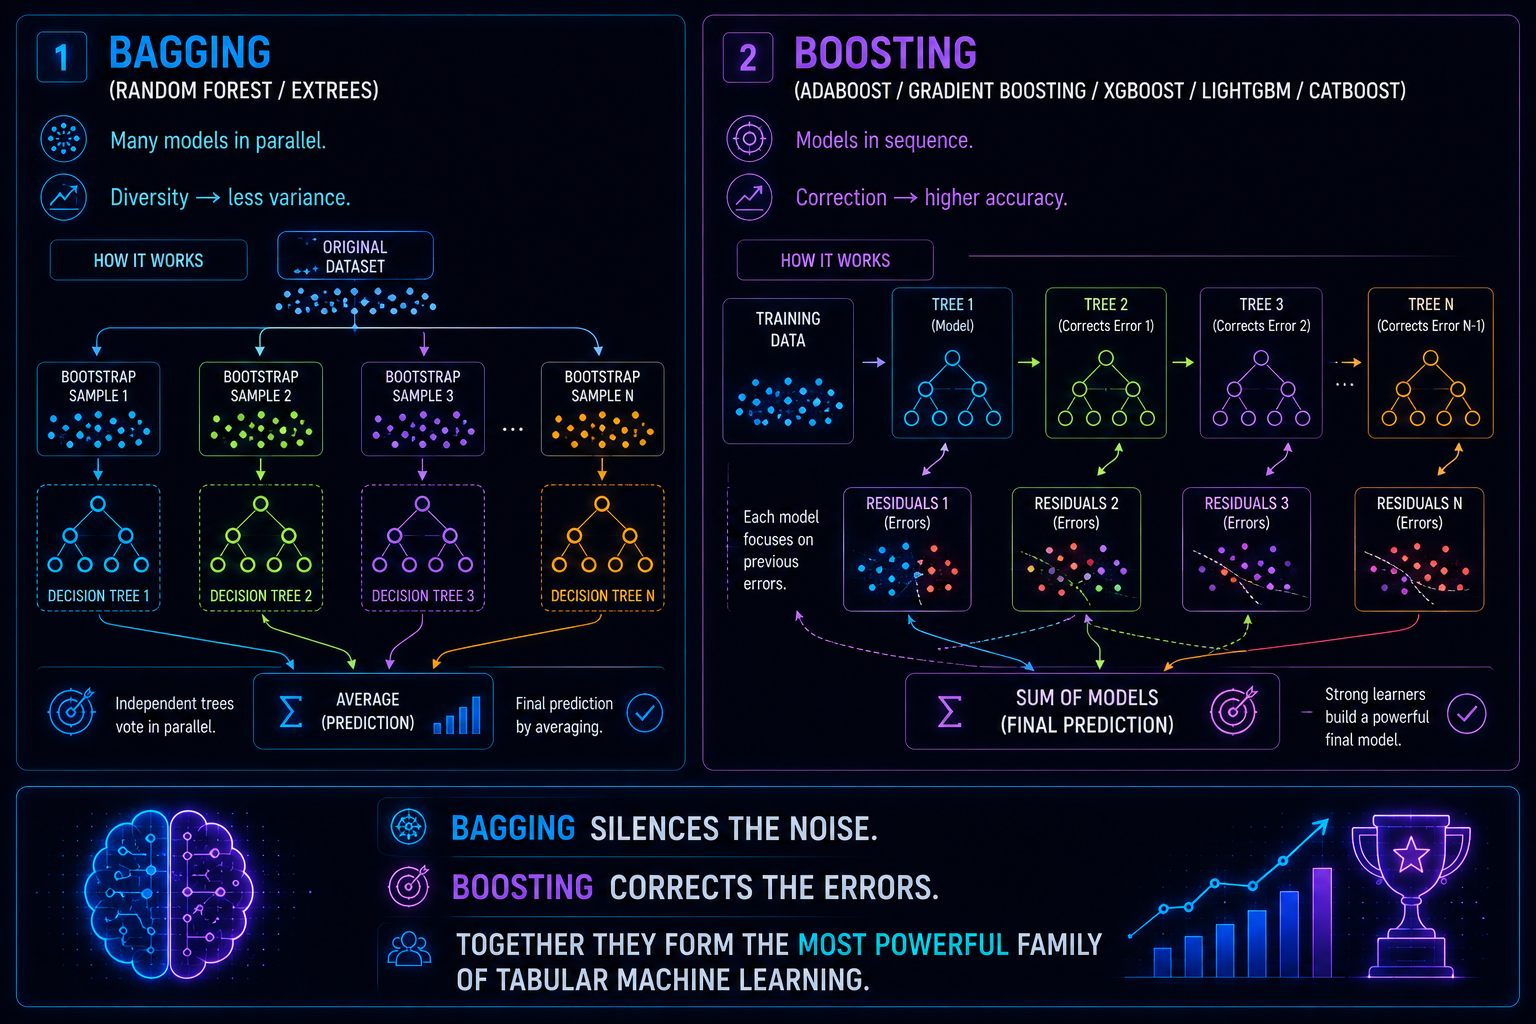
- Bagging → muchos modelos entrenados en paralelo, cada uno por su lado.
- Boosting → muchos modelos entrenados en secuencia, cada uno aprendiendo de los tropiezos del anterior.
Veamos cada filosofía con calma.
Bagging: el bosque que silencia el ruido
Random Forest + ExtraTrees
Bagging viene de Bootstrap Aggregating, que suena intimidante pero significa algo sencillo: entrenar muchos modelos en paralelo, darle a cada uno una muestra distinta de los datos, y luego promediar sus predicciones.
¿Por qué funciona tan bien con árboles de decisión? Porque los árboles tienen una virtud que parece un defecto: son inestables. Cambia un poco los datos y el árbol cambia mucho. Individualmente, eso los hace poco fiables. Pero cuando tienes cientos de árboles distintos y promedias sus votos, esa inestabilidad se cancela y el resultado se vuelve sorprendentemente estable. Es como preguntar a mil testigos ligeramente distraídos: cada uno recuerda mal un detalle, pero entre todos reconstruyen la escena perfecta.
De esta idea nacen dos clásicos.
Random Forest, el bosque más famoso
Random Forest hace dos trucos a la vez para forzar la diversidad. Primero, el bootstrap: cada árbol ve un subconjunto distinto de los datos. Segundo, el muestreo de variables: en cada división, el árbol solo puede elegir entre un puñado de características, no todas. El resultado son árboles genuinamente diferentes entre sí, y esa diversidad es el corazón del bagging.
Por eso Random Forest es tan querido: es robusto, dificilísimo de sobreajustar, funciona bien casi sin ajustar nada, tolera el ruido y los valores faltantes, y sirve como baseline excelente para casi cualquier problema tabular. Cuando no sabes por dónde empezar, empieza aquí.
ExtraTrees, la versión más caótica
ExtraTrees (Extremely Randomized Trees) sube la apuesta de la aleatoriedad. En lugar de buscar cuidadosamente el mejor corte en cada división, elige cortes al azar. Suena temerario, y lo es, pero funciona: al añadir más azar consigue árboles aún más diversos, entrena más rápido y reduce todavía más la varianza. Piénsalo como un Random Forest con más caos y menos cálculo.
Boosting: el algoritmo que aprende de sus errores
AdaBoost
El boosting es la filosofía contraria. En vez de entrenar modelos en paralelo y promediar, los entrena uno detrás de otro, y cada modelo nuevo se dedica a arreglar lo que el anterior hizo mal.
AdaBoost fue el primero en hacerlo bien, y su idea es preciosa por lo intuitiva. Cada vez que un punto se clasifica mal, se le sube el «peso», como si gritara más fuerte para pedir atención. El siguiente modelo, entonces, se concentra justo en esos puntos difíciles. Y así, ronda tras ronda, el comité va afinando precisamente donde más se equivoca. Al final combina todos los modelos, dando más voz a los que mejor lo hicieron.
Es, básicamente, un profesor que dedica más tiempo a los alumnos que suspenden.
Esa obsesión por los casos difíciles es su gran fuerza y también su talón de Aquiles. Con datos limpios, AdaBoost es simple, elegante y muy efectivo. Pero cuando hay ruido o outliers, esos puntos «raros» también reclaman atención, y el algoritmo puede acabar obsesionándose con errores que ni siquiera merecía la pena corregir. Traducción: con datos sucios, sufre.
Gradient Boosting: el padre de los modelos modernos
Gradient Boosting toma la idea de AdaBoost y la lleva al terreno de las matemáticas modernas. En lugar de subir pesos a los puntos difíciles, hace algo más general y más potente: cada nuevo árbol intenta predecir el error que dejó el anterior, usando el gradiente para saber en qué dirección corregir.
El ciclo es tan limpio que da gusto contarlo:
- Haces una predicción.
- Calculas el error que has cometido.
- Entrenas un árbol nuevo para corregir ese error.
- Repites el proceso.
- Sumas todos los árboles.
Cada árbol es un pequeño ajuste, un «casi, pero un poco más por aquí», y la suma de todos esos ajustes acaba siendo un modelo enormemente preciso. Es tan flexible y tan potente que se convirtió en la base sobre la que se construyeron los tres pesos pesados que vienen ahora: XGBoost, LightGBM y CatBoost.
XGBoost: el motor que ganó Kaggle
XGBoost cogió el Gradient Boosting y lo pulió hasta convertirlo en una máquina de competición. Le añadió una regularización fuerte para que no se sobreajustara, aprendió a manejar los valores faltantes por sí solo, se paralelizó para ir rápido y se optimizó de forma casi obsesiva.
El resultado fue demoledor con datos tabulares. Durante años, la receta para ganar una competición de Kaggle fue prácticamente una sola palabra: XGBoost. Su único pero es que sacarle todo el jugo exige un ajuste de hiperparámetros bastante fino.
LightGBM: velocidad pura
Cuando los datasets empezaron a crecer, XGBoost se quedaba un poco corto de velocidad, y ahí entró LightGBM con dos ideas ingeniosas.
La primera, entrenamiento por histogramas: en lugar de mirar cada valor posible uno por uno, agrupa los datos en cubos y trabaja mucho más rápido. La segunda, crecimiento por hojas en lugar de por niveles: el árbol crece justo donde más falta hace, profundizando en las zonas problemáticas en vez de expandirse de forma uniforme.
El resultado es un algoritmo rapidísimo, ideal para datasets grandes y para variables numéricas. El precio de esa profundidad es que, si no le pones límites, puede sobreajustar con facilidad.
CatBoost: el rey de las categorías
CatBoost llegó a resolver un dolor de cabeza histórico: cómo tratar las variables categóricas (país, marca, tipo de cliente…) sin recurrir al one-hot encoding, que infla los datos, ni caer en el temido leakage, cuando el modelo «hace trampa» mirando información que no debería.
Su solución es el ordered encoding: convierte las categorías en números sin espiar el futuro, es decir, calculando cada valor solo con la información disponible hasta ese momento. Así evita el leakage de raíz y se vuelve muy robusto con datasets llenos de categorías. No es casualidad que sea el favorito en banca, retail y seguros, sectores donde este tipo de variables lo dominan todo.
La foto de familia: cuándo usar cada uno
| Modelo | Mejor para | Ventajas | Riesgos |
|---|---|---|---|
| Random Forest | baseline, ruido | robusto y estable | menos preciso que boosting |
| ExtraTrees | velocidad | muy rápido y diverso | puede perder precisión |
| AdaBoost | datos limpios | simple y elegante | sufre con el ruido |
| Gradient Boosting | uso general | flexible y potente | lento sin optimizar |
| XGBoost | datos tabulares | regularización, missing values | ajuste complejo |
| LightGBM | datasets grandes | rapidísimo | riesgo de overfitting |
| CatBoost | variables categóricas | evita el leakage | más lento que LightGBM |
Como regla mental sencilla: empieza por Random Forest para tener una referencia, y si necesitas exprimir la última gota de precisión en datos tabulares, salta al boosting (XGBoost, LightGBM o CatBoost según tu problema).
En resumen
Los métodos ensemble son la demostración de una idea sorprendentemente poderosa por lo simple:
La diversidad vence al ruido. La colaboración vence al error. La suma vence a la fragilidad.
Y con esto, la familia queda casi completa:
Si PCA descubre dimensiones,
y LDA descubre fronteras,
y LSA descubre significados,
y t‑SNE descubre paisajes…
los métodos ensemble descubren fuerza en la multitud.
Son el algoritmo que mira tus modelos débiles, sonríe, y les dice:
«Juntos, somos mejores.»