

Regularización + Transfer Learning
Cómo evitar que las redes olviden, se saturen o se sobreajusten
El arte de domar redes profundas y enseñarles a aprender sin perderse en el camino.
En el capítulo anterior vimos cómo Backpropagation permite que una red aprenda: propaga el error hacia atrás, calcula gradientes y ajusta millones de pesos hasta dominar un patrón.
Pero aprender no es suficiente.
Aprender bien es lo que realmente importa.
Una red profunda puede memorizar el dataset, saturarse, olvidar lo aprendido, volverse inestable o sobreajustarse hasta quedar inútil con datos nuevos. Es como un estudiante que se sabe el libro de memoria, palabra por palabra… pero no entiende nada y se bloquea en cuanto le cambias la pregunta.
Para evitar eso, el Deep Learning desarrolló dos grandes herramientas:
- Regularización → evitar el sobreajuste.
- Transfer Learning → aprender más rápido reutilizando conocimiento previo.
Vamos con cada una.
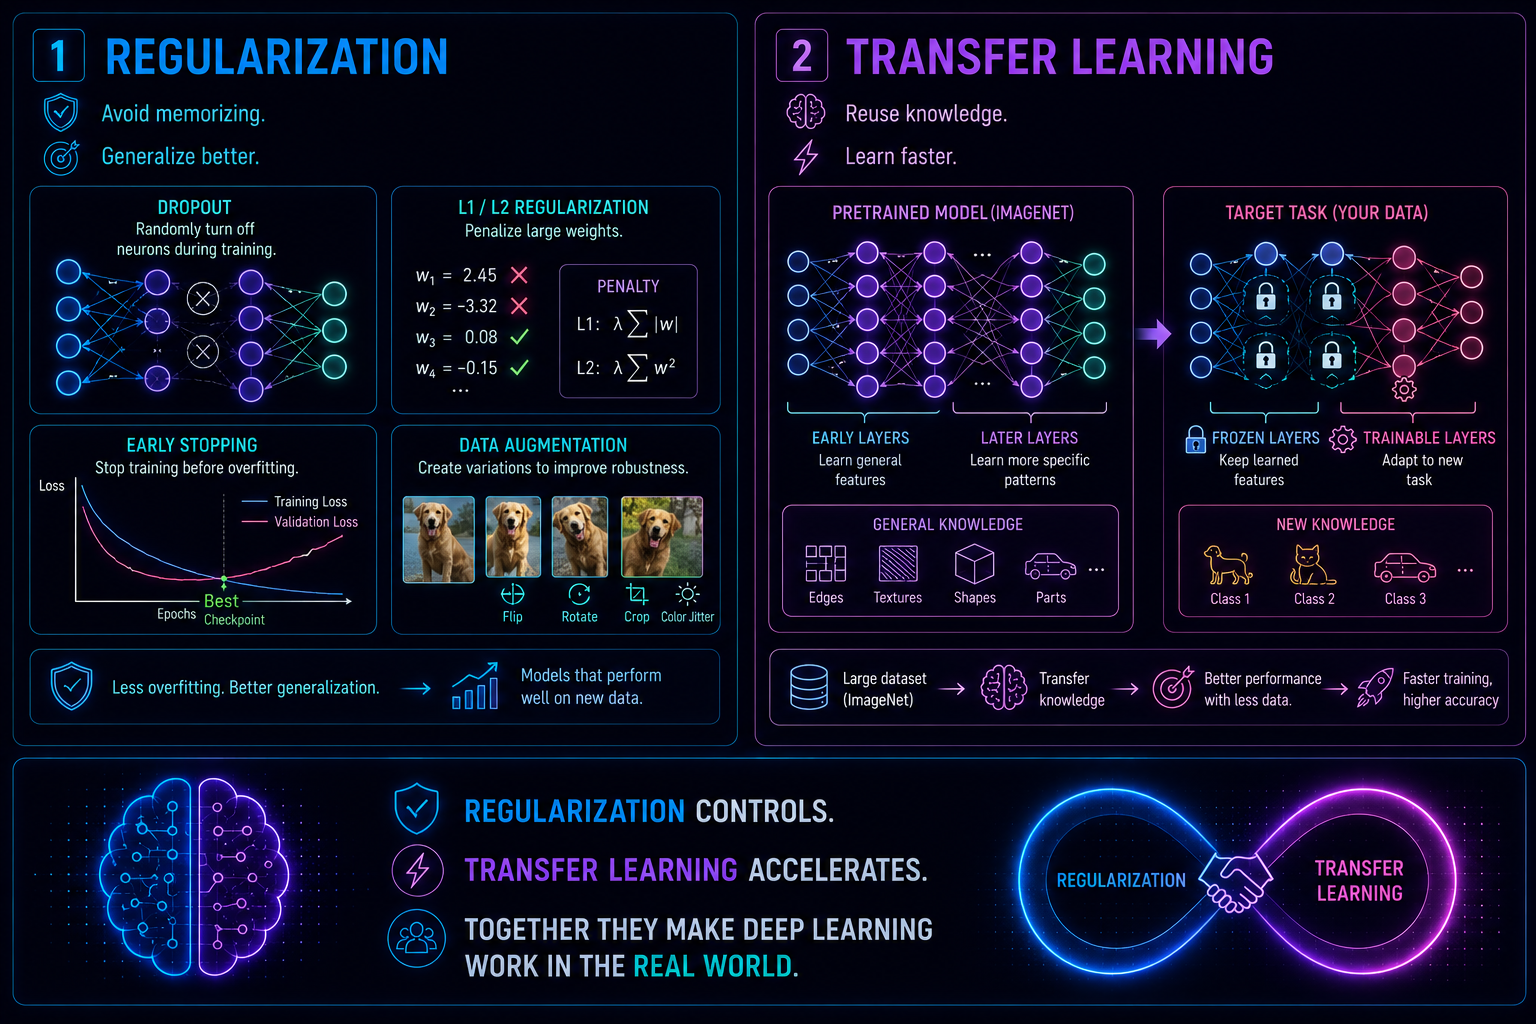
Regularización
Evitar que la red memorice y pierda la capacidad de generalizar
Una red profunda tiene millones de parámetros. Eso significa que, si la dejas sin control, puede aprender demasiado: memorizar cada ejemplo, cada ruido, cada detalle irrelevante del dataset.
La regularización es el arte de decirle:
«Aprende, pero no te obsesiones.»
Un ejemplo para verlo. Imagina un estudiante que memoriza los 100 exámenes de años anteriores letra por letra. En el simulacro saca un 10. Pero el día del examen real, con preguntas nuevas, se hunde: nunca aprendió el concepto, solo copió respuestas. Eso es exactamente el sobreajuste. La regularización obliga a la red a entender el patrón en lugar de memorizar el examen.
Hay varias formas de conseguirlo.
🔧 1. L1 y L2: penalizar pesos grandes
Son las regularizaciones clásicas:
- L1 empuja pesos hacia cero (crea redes sparse, con muchos pesos nulos).
- L2 empuja pesos hacia valores pequeños (los suaviza sin anularlos).
La idea es simple: si un peso es enorme, probablemente está memorizando ruido. Penalízalo. Es como decirle a la red: «confía menos en los detalles extremos.»
2. Dropout: apagar neuronas al azar
Dropout es una de las ideas más brillantes del Deep Learning. Durante el entrenamiento apagas neuronas al azar, y así obligas a la red a no depender de ninguna en particular. En la práctica estás entrenando muchas subredes distintas dentro de la misma red.
Es como un equipo de fútbol donde cada día falta un jugador diferente: todos aprenden a jugar bien sin depender de una sola estrella. El resultado es un equipo mucho más robusto, y una red que sobreajusta muchísimo menos.
3. Early Stopping: parar antes de que empeore
A veces la red empieza aprendiendo bien… y luego, si sigues entrenando, empieza a memorizar. Early Stopping vigila la pérdida en el conjunto de validación y dice:
«Hasta aquí. Si sigo, empeoro.»
Simple, elegante y muy efectivo.
4. Batch Normalization: estabilizar el aprendizaje
Las activaciones pueden saturarse, explotar o volverse inestables a medida que atraviesan las capas. BatchNorm normaliza cada capa durante el entrenamiento, y con eso estabiliza los gradientes, acelera el aprendizaje, reduce la sensibilidad a cómo inicializas los pesos y, de paso, actúa como regularizador.
Es como poner aire acondicionado en una fábrica: todo funciona mejor cuando la temperatura se mantiene estable.
5. Data Augmentation: crear datos nuevos
En visión, audio y texto puedes generar variaciones del dataset: rotaciones, recortes, ruido, cambios de brillo, sinónimos, reordenar palabras. La red ve más ejemplos y generaliza mejor.
Es como entrenar a un piloto en climas distintos: si solo practica con sol, fallará el día que llueva.
Transfer Learning
Aprender más rápido reutilizando conocimiento previo
Entrenar una red desde cero es caro, lento y requiere muchísimos datos. Pero… ¿y si empezamos desde una red que ya sabe cosas?
Eso es Transfer Learning: una red aprende un problema grande, y luego reutilizamos ese conocimiento para un problema pequeño.
Es como aprender a tocar el piano y después usar ese oído y esa técnica para aprender guitarra: no empiezas desde cero, arrancas con media carrera ya hecha.
La idea central
Una red entrenada en un dataset enorme (ImageNet, COCO, LibriSpeech…) aprende cosas muy generales: bordes, formas, texturas, patrones de sonido, estructuras lingüísticas.
Ese conocimiento es general. Sirve para muchísimos problemas distintos. Transfer Learning consiste en aprovecharlo:
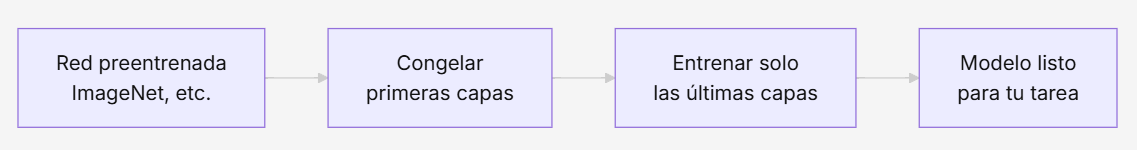
Tomas una red preentrenada, congelas sus primeras capas (las que capturan patrones generales) y entrenas solo las últimas para tu tarea específica. Es rápido, barato y extremadamente efectivo.
Dos formas de usarlo
| Feature Extraction | Fine-Tuning | |
|---|---|---|
| Qué haces | Usas la red como extractor de características y entrenas solo un clasificador encima | Descongelas algunas capas y las reajustas con tu dataset |
| Cuánto entrenas | Solo la capa final | Varias capas |
| Ideal cuando | Tienes pocos datos | Tienes más datos o tu tarea es muy distinta del preentrenamiento |
| Coste | Muy bajo | Medio |
¿Por qué funciona tan bien?
Porque las primeras capas de una red profunda aprenden patrones universales: bordes, curvas, texturas, frecuencias, estructuras sintácticas. Y esos patrones son útiles para casi cualquier tarea.
Transfer Learning es el superpoder del Deep Learning moderno: permite entrenar modelos de clase mundial con datasets pequeños.
En resumen
La regularización evita que la red memorice. El Transfer Learning evita que tengas que entrenarla desde cero.
Juntas forman el dúo que hace que el Deep Learning sea estable, generalizable, eficiente, accesible y práctico en el mundo real.
- Sin regularización, las redes se saturan y memorizan.
- Sin Transfer Learning, serían demasiado lentas y costosas para la mayoría.
Y ahora que sabemos cómo controlar y reutilizar redes…
En la próxima serie entramos en las arquitecturas modernas: CNNs, RNNs, Attention y Transformers.