

Backpropagation
El algoritmo que enseñó a las redes a aprender
Cómo una idea tan simple como «propagar el error hacia atrás» desbloqueó todo el Deep Learning moderno.
En el capítulo anterior vimos cómo el MLP —esa cadena de perceptrones conectados— es capaz de aprender patrones que un perceptrón jamás podría capturar. Pero dejamos una pregunta abierta, casi incómoda:
¿Cómo se ajustan todos esos pesos?
Un perceptrón tiene unos pocos parámetros. Un MLP tiene miles. Una red profunda, millones.
Cuando la red se equivoca, ¿cómo sabe cada neurona cuánto debe corregir? ¿Cómo se reparte la culpa del error entre millones de parámetros? ¿Cómo se decide qué peso subir, cuál bajar y en qué proporción?
La respuesta es uno de los algoritmos más influyentes de la historia del aprendizaje automático.
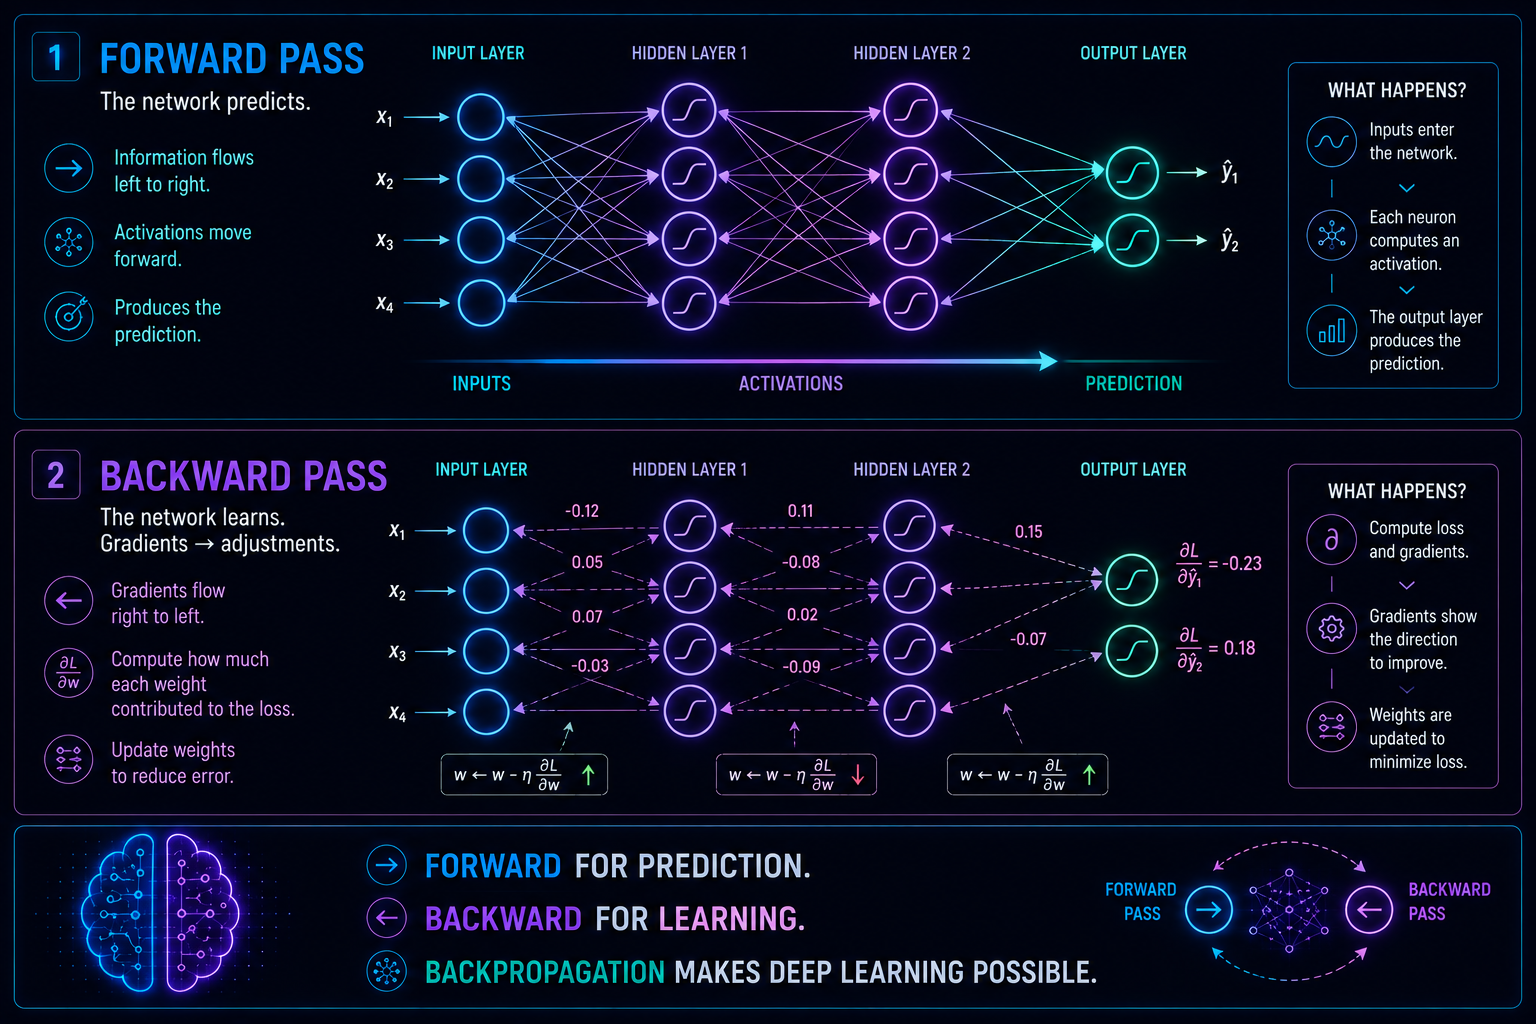
Backpropagation.
El problema: aprender no es trivial
Imagina una red con tres capas ocultas. La entrada pasa por la primera capa, luego por la segunda, luego por la tercera, y finalmente llega a la salida.
Cada capa transforma los datos. Cada neurona aplica una función. Cada peso influye en el resultado final.
Cuando la red falla, el error aparece en la salida. Pero los pesos que causaron ese error están repartidos por toda la red.
Es como intentar corregir un fallo en una fábrica con cientos de máquinas conectadas en cadena: la pieza final salió defectuosa, pero… ¿en qué máquina se torció? ¿En la primera? ¿En la segunda? ¿En todas un poquito?
Necesitamos un método para rastrear el error hacia atrás: para saber cómo cada peso contribuyó al fallo y ajustar cada uno en la dirección correcta.
Eso es Backpropagation.
La idea central: propagar el error hacia atrás
Backpropagation hace algo conceptualmente simple:
- Calcula el error en la salida.
- Lo reparte hacia atrás, capa por capa.
- Calcula cuánto contribuyó cada peso a ese error.
- Ajusta cada peso en la dirección que reduce el error.
Es una cadena de responsabilidades. Una auditoría matemática. Un «¿quién tuvo la culpa?» distribuido por toda la red.
Y la magia está en cómo se hace ese reparto: usando derivadas encadenadas. La famosa regla de la cadena.
La regla de la cadena: el corazón del algoritmo
Cuando una red tiene varias capas, la salida depende de la entrada a través de una composición de funciones:
Si quieres saber cómo cambia la salida al mover un peso de la primera capa, tienes que derivar una función que está dentro de otra, que a su vez está dentro de otra. La regla de la cadena dice exactamente cómo hacerlo:
Es como seguir un rastro: cada derivada te dice cómo un pequeño cambio se propaga a través de la red, eslabón a eslabón.
Backpropagation no es más que aplicar esta regla de forma eficiente, reutilizando cálculos en lugar de repetirlos.
Un ejemplo para verlo. Piensa en una receta con tres pasos: cortas, cocinas y sazonas. El plato final sale demasiado salado. Para arreglarlo no cambias los tres pasos a lo loco: rastreas hacia atrás y descubres que el problema estaba en el último paso, la sal. La regla de la cadena hace justo eso, pero midiendo con precisión cuánta «culpa» tiene cada paso en el sabor final.
El ciclo completo: cómo aprende una red neuronal
El entrenamiento de una red sigue siempre el mismo ciclo de cuatro fases:
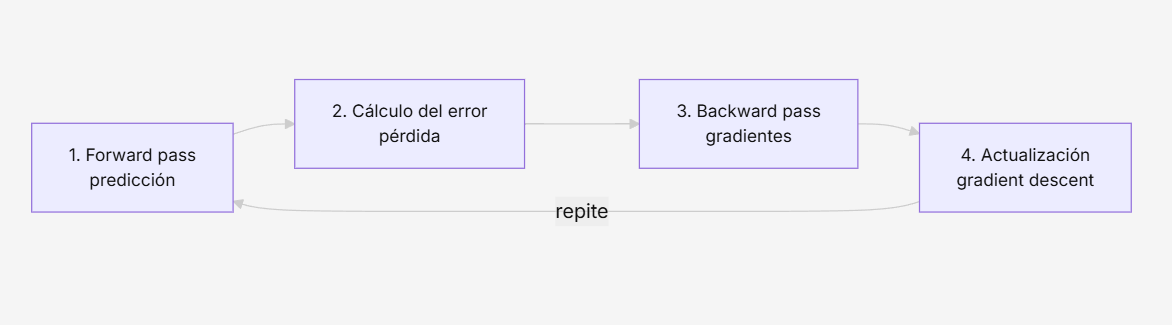
1. Forward pass. La entrada fluye hacia adelante. Cada capa transforma los datos. La red produce una predicción.
2. Cálculo del error. Comparas la predicción con la etiqueta real y obtienes una pérdida: una medida de cuánto se equivocó.
3. Backward pass (Backpropagation). El error se propaga hacia atrás. Cada peso recibe su parte de culpa. Se calculan los gradientes.
4. Actualización de pesos (Gradient Descent). Cada peso se ajusta un poco en la dirección que reduce la pérdida.
Y repites. Miles de veces. Millones de veces. Hasta que la red aprende.
La intuición: enseñar corrigiendo
Backpropagation es, en el fondo, un profesor paciente:
- mira el error final,
- lo reparte entre los responsables,
- corrige a cada uno un poquito,
- y vuelve a empezar.
Una y otra vez.
Es aprendizaje incremental. Pequeños ajustes que, acumulados, terminan creando modelos capaces de reconocer caras, traducir idiomas, describir imágenes, escribir textos y predecir secuencias.
Sin Backpropagation, el Deep Learning moderno no existiría.
¿Por qué fue tan revolucionario?
Porque resolvió tres problemas de golpe:
1. Aprender en redes profundas. Antes, nadie sabía cómo ajustar los pesos de las capas ocultas. Backpropagation lo hizo posible.
2. Escalar a millones de parámetros. El algoritmo es eficiente: usa prácticamente las mismas operaciones que el forward pass, pero en sentido inverso.
3. Funcionar con cualquier arquitectura. MLP, CNN, RNN, Transformers… todas aprenden gracias a Backpropagation.
Es el motor que mueve todo el Deep Learning.
En resumen
Backpropagation es el algoritmo que enseñó a las redes a aprender:
- propaga el error hacia atrás,
- calcula la responsabilidad de cada peso,
- ajusta cada parámetro con gradiente,
- y repite hasta que la red domina el patrón.
Es la pieza que faltaba. El puente entre el MLP y el Deep Learning moderno. El mecanismo que permitió que las redes dejaran de ser un concepto bonito y se convirtieran en una herramienta real.
Y ahora que sabemos cómo aprenden…
En el próximo capítulo veremos cómo evitar que olviden, se saturen o se sobreajusten: Regularización + Transfer Learning.